安装
:::python 安装langgraph:
langgraph:
定义和更新状态
这里我们展示如何在 LangGraph 中定义和更新 状态。我们将演示:定义状态
:::python LangGraph 中的 State 可以是一个TypedDict、Pydantic 模型,或数据类。下面我们将使用 TypedDict。有关使用 Pydantic 的详细信息,请参阅 使用 Pydantic 模型作为图状态。
:::
:::js
LangGraph 中的 State 是使用 StateSchema 类定义的。这提供了一个统一的 API,它接受 标准模式(如 Zod)作为单个字段的模式,以及特殊值类型如 ReducedValue、MessagesValue 和 UntrackedValue。
:::
默认情况下,图将具有相同的输入和输出模式,状态决定了该模式。有关如何定义不同的输入和输出模式的详细信息,请参阅 定义输入和输出模式。
:::python
让我们考虑一个使用 消息 的简单示例。这代表了许多 LLM 应用中状态的通用形式。有关更多详细信息,请参阅我们的 概念页面。
:::
:::js
让我们考虑一个使用 消息 的简单示例。这代表了许多 LLM 应用中状态的通用形式。有关更多详细信息,请参阅我们的 概念页面。
:::
:::python
更新状态
:::python 让我们构建一个只有一个节点的示例图。我们的 node 只是一个读取图状态的 Python 函数,并对状态进行更新。这个函数的第一个参数始终是状态:StateGraph 来定义一个操作此状态的图。然后我们使用 add_node 来填充我们的图。
StateGraph 来定义一个操作此状态的图。然后我们使用 addNode 来填充我们的图。
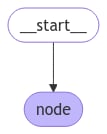
- 我们通过更新状态的一个键来启动调用。
- 我们在调用结果中接收整个状态。
使用 reducer 更新状态
状态中的每个键都可以有自己的独立 reducer 函数,该函数控制节点更新如何应用。如果没有显式指定 reducer 函数,则假定所有对键的更新都应该覆盖它。 :::python 对于TypedDict 状态模式,我们可以通过在状态的相关字段上注解 reducer 函数来定义 reducer。
在之前的示例中,我们的节点通过向 "messages" 键追加消息来更新状态。下面,我们为这个键添加一个 reducer,以便自动追加更新:
MessagesValue,它已经具有内置的 reducer。对于自定义字段,你可以使用 ReducedValue 来定义如何应用更新。
在之前的示例中,我们的节点通过向 "messages" 键追加消息来更新状态。MessagesValue reducer 自动处理这一点:
消息状态
在实际应用中,更新消息列表时需要考虑以下额外因素: LangGraph 包含一个内置的 reducer @[add_messages],用于处理这些考虑因素:
MessagesState 以方便使用,因此我们可以实现:
消息值
在实际应用中,更新消息列表时需要考虑以下几点: LangGraph 包含内置的MessagesValue 来处理这些考虑:
MessagesValue 以方便使用,因此我们可以实现:
使用 Overwrite 跳过 reducer
在某些情况下,您可能希望跳过 reducer 并直接覆盖状态值。LangGraph 提供了用于此目的的 Overwrite 类型。当节点返回一个用 Overwrite 包装的值时,reducer 会被跳过,并且通道会直接设置为该值。
当您希望重置或替换累积状态,而不是将其与现有值合并时,这很有用。
"__overwrite__" 的 JSON 格式:
使用 Overwrite 跳过 reducer
在某些情况下,您可能希望跳过 reducer 并直接覆盖状态值。LangGraph 提供了 Overwrite 类型用于此目的。当节点返回一个用 Overwrite 包装的值时,reducer 会被跳过,并且通道会直接设置为该值。
当您希望重置或替换累积状态,而不是将其与现有值合并时,这很有用。
"__overwrite__" 的 JSON 格式:
定义输入和输出模式
默认情况下,StateGraph 使用单一模式进行操作,所有节点都预期使用该模式进行通信。然而,也可以为图定义不同的输入和输出模式。
当指定不同的模式时,节点之间的通信仍然会使用内部模式。输入模式确保提供的输入符合预期结构,而输出模式则过滤内部数据,仅返回根据定义的输出模式相关的信息。
下面,我们将展示如何定义不同的输入和输出模式。
:::python
在节点间传递私有状态
在某些情况下,你可能希望节点之间交换对中间逻辑至关重要但不需要成为图主要模式一部分的信息。这种私有数据与图的整体输入/输出无关,并且只应在特定节点之间共享。 下面,我们将创建一个由三个节点(node_1、node_2 和 node_3)组成的顺序图示例,其中私有数据在第一步(node_1)和第二步(node_2)之间传递,而第三步(node_3)仅能访问公开的整体状态。 :::python使用 pydantic 模型定义图状态
一个 @[StateGraph] 在初始化时接受一个 @[state_schema] 参数,用于指定图中节点可以访问和更新的状态的”结构”。
在我们的示例中,我们通常使用一个原生 TypedDict 或 dataclass(用于 state_schema),但 @[state_schema] 可以是任何 类型。
在这里,我们将看到如何使用 Pydantic BaseModel 作为 @[state_schema] 来为 输入 添加运行时验证。
已知限制
- 目前,图的输出不会是 pydantic 模型的实例。
- 运行时验证仅发生在图中第一个节点的输入上,而不是后续节点或输出。
- pydantic 的验证错误跟踪不会显示错误发生在哪个节点。
- Pydantic 的递归验证可能很慢。对于性能敏感的应用,您可能希望考虑使用一个
dataclass代替。
Serialization Behavior
Serialization Behavior
当使用 Pydantic 模型作为状态模式时,了解序列化工作原理非常重要,尤其是在以下情况:
- 将 Pydantic 对象作为输入传递
- 接收来自图的输出
- 处理嵌套的 Pydantic 模型
Runtime Type Coercion
Runtime Type Coercion
Pydantic 对某些数据类型执行运行时类型强制转换。这可能会很有帮助,但如果您不了解它,也可能导致意外行为。
Working with Message Models
Working with Message Models
当在状态模式中使用 LangChain 消息类型时,序列化方面有一些重要的注意事项。在使用消息对象进行网络传输时,您应该使用
AnyMessage(而不是 BaseMessage)进行正确的序列化/反序列化。可选的状态定义方式
虽然StateSchema 是定义状态推荐的方法,但 LangGraph 支持多种其他方式。本节涵盖所有可用选项。
通道 API
通道 API 提供了对状态管理的底层控制。LangGraph 提供了多种内置通道类型:
使用对象简写:
当你传递包含
reducer 和 default 的对象时,它会创建一个 BinaryOperatorAggregate 通道。传递 null 创建一个 LastValue 通道:
Annotation.Root
Annotation.Root 提供了一种声明式的方式来定义带有 reducer 的状态。它与 StateSchema 类似,但使用了不同的语法:
Zod v3 中的 Zod 对象
在使用 Zod v3 时,您可以使用纯z.object() 模式定义状态。LangGraph 通过 .langgraph 插件扩展 Zod v3,该插件提供 .reducer() 和 .metadata() 方法:
Zod v4 中的 Zod 对象
Zod v4 使用基于注册表的方法。使用 LangGraph 注册表将元数据附加到模式字段:对比表格
添加运行时配置
有时您希望在调用图时能够配置它。例如,您可能希望能够在运行时指定要使用的 LLM 或系统提示词,而不会用这些参数污染图状态。 要添加运行时配置:- 为您的配置指定一个架构
- 将配置添加到节点或条件边的函数签名中
- 将配置传递给图。
Extended example: specifying LLM at runtime
Extended example: specifying LLM at runtime
:::python
下面我们演示了一个实际示例,其中我们在运行时配置要使用的 LLM。我们将使用 OpenAI 和 Anthropic 模型。::::::js
下面我们演示了一个实际示例,其中我们在运行时配置要使用的 LLM。我们将使用 OpenAI 和 Anthropic 模型。:::
Extended example: specifying model and system message at runtime
Extended example: specifying model and system message at runtime
:::python
下面我们演示了一个实际示例,其中我们配置了两个参数:运行时要使用的 LLM 和系统消息。::::::js
下面我们演示了一个实际示例,其中我们配置了两个参数:运行时要使用的 LLM 和系统消息。:::
添加重试策略
在许多场景中,您可能希望您的节点具有自定义的重试策略,例如调用 API、查询数据库或调用大型语言模型(LLM)等。LangGraph 允许您为节点添加重试策略。 :::python 要配置重试策略,将retry_policy 参数传递给 @[add_node]。retry_policy 参数接收一个 RetryPolicy 命名元组对象。下面我们使用默认参数实例化一个 RetryPolicy 对象,并将其与节点关联:
retry_on 参数使用 default_retry_on 函数,该函数会在除以下异常之外的所有异常上进行重试:
ValueErrorTypeErrorArithmeticErrorImportErrorLookupErrorNameErrorSyntaxErrorRuntimeErrorReferenceErrorStopIterationStopAsyncIterationOSError
requests 和 httpx 等流行 HTTP 请求库的异常,它仅在 5xx 状态码时进行重试。
:::
:::js
要配置重试策略,将 retryPolicy 参数传递给 addNode。retryPolicy 参数接收一个 RetryPolicy 对象。下面我们使用默认参数实例化一个 RetryPolicy 对象,并将其与节点关联:
TypeErrorSyntaxErrorReferenceError:::
Extended example: customizing retry policies
Extended example: customizing retry policies
:::python
考虑一个从 SQL 数据库读取的示例。下面我们将两种不同的重试策略传递给节点:::::::js
考虑一个从 SQL 数据库读取的示例。下面我们将两种不同的重试策略传递给节点::::
设置节点超时
使用timeout 参数与 @[add_node] 限制单个异步节点调用的运行时长。以秒为单位提供超时时间或作为 datetime.timedelta。
timeout,LangGraph 在图编译时会抛出错误,因为同步 Python 执行无法在进程内安全取消。
当节点超出其超时时,LangGraph 会抛出 NodeTimeoutError,该异常继承自 Python 的内置 TimeoutError。如果节点具有 retry_policy 并重试 TimeoutError 或 NodeTimeoutError,超时的尝试会被重试。超时独立应用于每次尝试,因此计时器会在每次重试时重置。
超时的尝试不会提交其缓存的写入。这防止了状态更新或子任务调度在超时边界后泄漏。
配置节点超时
@[add_node] 上的 timeout= 参数控制单个异步节点尝试运行的最长时间。传递一个数字(秒)、一个 timedelta 或一个 @[TimeoutPolicy] 以对运行和空闲超时进行更精细的控制。当超出限制时,LangGraph 会引发 @[NodeTimeoutError] 并让重试策略决定是否重试。
节点级超时需要
langgraph>=1.2。runtime.heartbeat()。
处理节点错误
在 @[add_node] 上的 error_handler= 参数注册一个函数,该函数在节点失败且所有重试均耗尽后执行。该处理器接收当前状态和一个带有失败上下文的 typed @[NodeError],可以通过 @[Command] 路由到恢复分支:
节点级错误处理器需要
langgraph>=1.2。Command 路由。
设置全局节点默认值
需要
langgraph>=1.2。set_node_defaults] 为图中的每个节点设置 retry_policy、timeout、cache_policy 或 error_handler,而不是在每个 @[add_node] 调用中重复它们。每个节点的值总是优先,默认值在 @[StateGraph.compile] 时应用:
retry_policy 和 timeout 默认值适用于每个节点,包括错误处理节点。cache_policy 和 error_handler 默认值仅适用于常规节点——处理程序从不捕获自身,并且缓存处理程序结果是不安全的。默认值不会被子图继承。
参见 容错 了解完整的优先级规则和应用性表。
:::
:::python
在节点内访问执行信息
您可以通过runtime.execution_info 访问执行身份和重试信息。这会显示线程、运行和检查点标识符以及重试状态,而无需直接从 config 读取。
访问线程和运行 ID
使用execution_info 在节点内访问线程 ID、运行 ID 和其他身份字段:
根据重试状态调整行为
当节点具有重试策略时,使用execution_info 检查当前尝试次数,并在第一次尝试失败后切换到回退:
execution_info 即使没有重试策略,也存在于 Runtime 对象上 — node_attempt 默认为 1,node_first_attempt_time 设置为节点开始执行的时间。
在节点内访问服务器信息
当您的图在 LangGraph Server 上运行时,您可以通过runtime.server_info 访问服务器特定的元数据。这会显示助手 ID、图 ID 和经过身份验证的用户,而无需直接从配置元数据或可配置键读取。
server_info 是 None,当图不在 LangGraph Server 上运行时(例如,在本地开发或测试期间)。
需要
deepagents>=0.5.0(或 langgraph>=1.1.5)用于 runtime.execution_info 和 runtime.server_info。在节点内部访问排空状态
当请求了 优雅关闭 时,runtime.drain_requested 是 True。在节点内部读取此状态以在下一个超级步骤边界之前跳过昂贵的操作:
需要
langgraph>=1.2。参见 优雅关闭 获取完整的 RunControl API。在节点内部访问执行信息
您可以通过runtime.executionInfo 访问执行身份和重试信息。这会暴露线程、运行和检查点标识符以及重试状态,而无需直接从 config 读取。
访问线程和运行 ID
使用executionInfo 在节点内部访问线程 ID、运行 ID 和其他身份字段:
根据重试状态调整行为
当节点具有重试策略时,使用executionInfo 检查当前尝试次数,并在第一次尝试失败后切换到回退方案:
executionInfo 即使没有重试策略,也存在于 Runtime 对象上 — nodeAttempt 默认为 1,nodeFirstAttemptTime 设置为节点开始执行的时间。
在节点内部访问服务器信息
当您的图在 LangGraph Server 上运行时,您可以通过runtime.serverInfo 访问服务器特定的元数据。
serverInfo 是 null,当图不在 LangGraph Server 上运行时。
需要
deepagents>=1.9.0(或 @langchain/langgraph>=1.2.8)用于 runtime.executionInfo 和 runtime.serverInfo。添加节点缓存
在需要避免重复操作的场景中,节点缓存非常有用,例如执行耗时或成本高昂的操作时。LangGraph 允许您为图中的节点添加个性化的缓存策略。 要配置缓存策略,请将cache_policy 参数传递给 @[add_node] 函数。在以下示例中,使用 120 秒的生存时间和默认的 key_func 生成器实例化了一个 @[CachePolicy] 对象,然后将其与一个节点关联:
cache 参数。下面的示例使用 InMemoryCache 设置了一个具有内存缓存的图,SqliteCache 也是可用的。
创建步骤序列
前提条件
本指南假定您熟悉上一节关于 状态 的内容。
- 如何构建顺序图
- 构建类似图的内置简写方式。
add_node] 和 @[add_edge] 方法:
.add_sequence:
.addNode 和 .addEdge 方法:
Why split application steps into a sequence with LangGraph?
Why split application steps into a sequence with LangGraph?
LangGraph 可以轻松地为您的应用程序添加底层持久化层。
这允许在节点执行之间检查点状态,因此您的 LangGraph 节点控制:它们还决定了执行步骤如何 流式输出,以及您的应用程序如何使用 Studio 进行可视化和调试。让我们演示一个端到端的示例。我们将创建一个包含三个步骤的序列:::::::js::::::python
我们的 节点 只是读取图状态并对其进行更新的 Python 函数。此函数的第一个参数始终是状态:::::::js
我们的 节点 只是读取图状态并对其进行更新的 TypeScript 函数。此函数的第一个参数始终是状态::::最后,我们定义图。我们使用 StateGraph 来定义一个在状态上操作的图。:::python
然后我们将使用 :::我们将使用 ::::::python::::::js:::注意::::python::::::js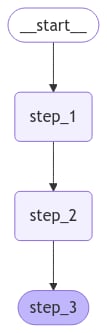
- 在状态的一个键中填充一个值
- 更新相同的值
- 填充不同的值
注意,在向状态发布更新时,每个节点只需指定它希望更新的键的值。默认情况下,这将 覆盖 对应键的值。您也可以使用 reducer 来控制更新如何处理——例如,您可以追加连续的更新到键中。有关更多详细信息,请参阅 使用 reducer 处理状态更新。
add_node 和 add_edge 来填充我们的图并定义其控制流。[addNode](/langchain/oss/langgraph/graph-api#节点) 和 [addEdge](/langchain/oss/langgraph/graph-api#边缘) 来填充我们的图并定义其控制流。- @[
add_edge] 接收节点的名称,对于函数默认为node.__name__。 - 我们必须指定图的入口点。为此,我们添加一个指向
[START node](/langchain/oss/langgraph/graph-api#start-节点)的边。 - 当没有更多节点可执行时,图将停止。
[compile](/langchain/oss/langgraph/graph-api#编译您的图) 图。这会提供一些关于图结构的基本检查(例如,识别孤立节点)。如果我们通过 [checkpointer](/langchain/oss/langgraph/persistence) 为应用程序添加持久化,它也会在这里传递。.addEdge接收节点的名称,对于函数默认为node.name。- 我们必须指定图的入口点。为此,我们添加一个指向
[START node](/langchain/oss/langgraph/graph-api#start-节点)的边。 - 当没有更多节点可执行时,图将停止。
[compile](/langchain/oss/langgraph/graph-api#编译您的图) 图。这会提供一些关于图结构的基本检查(例如,识别孤立节点)。如果我们通过 [checkpointer](/langchain/oss/langgraph/persistence) 为应用程序添加持久化,它也会在这里传递。
:::LangGraph 提供了内置工具来可视化您的图。让我们检查我们的序列。有关可视化的详细信息,请参阅 [Visualize your graph](#可视化你的图)。:::python- 我们通过为单个状态键提供值来启动调用。我们必须始终至少提供一个键的值。
- 我们传递的值被第一个节点覆盖。
- 第二个节点更新了值。
- 第三个节点填充了不同的值。
创建分支
并行执行节点对于加速整体图操作至关重要。LangGraph 提供了对节点并行执行的本地支持,这可以显著提升基于图的流程的性能。这种并行化是通过扇出(fan-out)和扇入(fan-in)机制实现的,同时利用标准边和 @[conditional_edges][add_conditional_edges]。以下是一些示例,展示如何添加适合您的分支化数据流。并行运行图节点
在这个示例中,我们从Node A 分叉到 B and C,然后汇聚到 D。通过我们的状态,我们指定了 reducer 添加操作。这将组合或累积状态中特定键的值,而不是简单地覆盖现有值。对于列表,这意味着将新列表与现有列表连接起来。有关使用 reducer 更新状态的更多详细信息,请参阅上一节关于 状态 reducer 的内容。
:::python
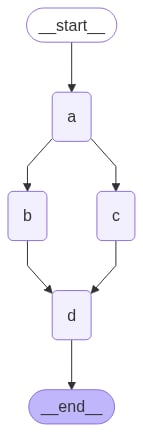
在上述示例中,节点
"b" 和 "c" 在同一个 超步 中并发执行。因为它们处于同一步骤中,所以节点 "d" 在 "b" 和 "c" 都完成后执行。重要的是,并行超步中的更新可能不会按一致的顺序进行。如果你需要一个一致的、预定的并行超步中的更新顺序,你应该将输出写入状态中的单独字段,并附带一个用于排序它们的值。Exception handling?
Exception handling?
LangGraph 在 超步 内执行节点,这意味着虽然并行分支会并行执行,但整个超步是 事务性 的。如果这些分支中的任何一个引发异常,没有任何 更新会被应用到状态(整个超步出错)。重要的是,当使用 检查点器 时,超步中成功节点的结果会被保存,并且在恢复时不会重复。如果你处理的是易出错的(也许想处理不可靠的 API 调用),LangGraph 提供了两种方法来解决这个问题:
- 你可以在节点内编写常规的 python 代码来捕获和处理异常。
- 你可以设置一个
RetryPolicy来指示图重试引发特定类型异常的节点。只有失败的分支会被重试,因此你无需担心执行冗余工作。
延迟节点执行
延迟节点执行在你想要将节点的执行推迟到所有其他挂起的任务都完成时非常有用。这在分支长度不同的情况下尤其相关,这在 map-reduce 流等工作流中很常见。 上面的例子展示了当每个路径只有一个步骤时如何进行发散和收敛。但如果一个分支有多个步骤怎么办?让我们在"b" 分支中添加一个节点 "b_2":
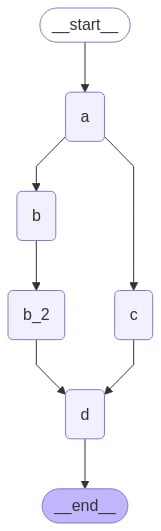
"b" 和 "c" 在同一个超级步骤中并发执行。我们在节点 d 上设置了 defer=True,所以它会在所有挂起的任务完成之前不会执行。在这种情况下,这意味着 "d" 会等待 "b" 分支完全完成后才执行。
当每个分支总是运行时,你可以使用列表形式的边代替 defer=True 来等待。add_edge 也接受一个起始节点列表。这不是简写为多个 add_edge 调用;这两种形式的行为不同:
- 起始节点列表 运行
d一次,在列出的所有节点都完成后。如果其中一个永远不会运行(例如,条件边没有选择其分支),d从不运行,也不会抛出错误。已完成分支的状态更新仍然保留在图状态中,但d不会消费它们。 - 单独的边 在任何传入分支完成的超级步骤中运行
d一次。对于等长的分支,这是一个单次运行;对于不同长度的分支,d会运行多次。 - 带有
defer=True的单独边(上面例子中的模式)在所有选定的分支都完成后运行d一次,无论发散是否选择了所有分支还是仅选择了一些分支。
defer=True 将节点推迟到图中任何地方都没有挂起的任务时,而不仅仅是为其提供输入的分支。一个指向该节点的 Send 仍然会单独调用它。
:::
条件分支
:::python 如果您的 fan-out 应该在运行时根据状态变化,您可以使用 @[add_conditional_edges] 通过图状态选择一个或多个路径。以下示例中,节点 a 生成一个状态更新,该更新决定了后续节点。
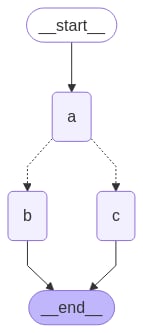
addConditionalEdges 通过图状态选择一个或多个路径。以下示例中,节点 a 生成一个状态更新,该更新决定了后续节点。
Map-Reduce 和 send API
LangGraph 支持使用 Send API 实现 map-reduce 和其他高级分支模式。以下是如何使用它的示例: :::python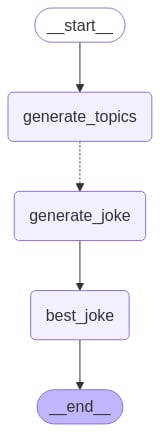
创建和控制循环
在创建包含循环的图时,我们需要一种终止执行的方法。这通常通过添加一个 条件边 来实现,该边在满足某些终止条件时将路由到 END 节点。 您也可以在调用或流式传输图时设置图的循环限制。循环限制设置了图允许执行的 超步 数量,之后会引发错误。了解更多关于 循环限制概念 的信息。 让我们考虑一个简单的带循环的图,以更好地理解这些机制的工作原理。 在创建循环时,您可以包含一个指定终止条件的条件边: :::python"recursion_limit"。这将引发一个 GraphRecursionError,您可以捕获并处理:
"recursionLimit"。这将引发一个 GraphRecursionError,您可以捕获并处理:
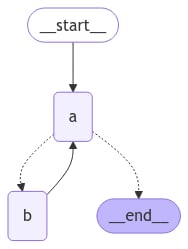
"a" 是一个工具调用模型,节点 "b" 表示工具。
在我们的 route 条件边中,我们指定在状态中的 "aggregate" 列表达到阈值长度后应结束。
调用图时,我们看到我们在节点 "a" 和 "b" 之间交替,直到达到终止条件。
:::python
强制循环限制
在某些应用中,我们可能无法保证会达到给定的终止条件。在这些情况下,我们可以设置图的 循环限制。这将在一个给定的 超步 数量后引发一个GraphRecursionError。然后我们可以捕获并处理此异常:
:::python
Extended example: return state on hitting recursion limit
Extended example: return state on hitting recursion limit
与引发
GraphRecursionError 相比,我们可以向状态引入一个新的键来跟踪达到循环限制前的剩余步数。然后我们可以使用此键来确定是否应结束运行。LangGraph 实现了一个特殊的 RemainingSteps 注释。在底层,它创建了一个 ManagedValue 通道——一个状态通道,它将在我们的图运行期间存在,之后不再存在。Extended example: loops with branches
Extended example: loops with branches
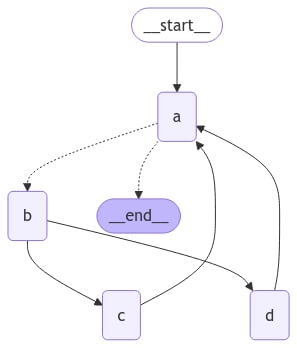
异步
使用异步编程范式可以在运行 IO密集 代码并发时(例如,向对话模型提供者并发发起 API 请求)带来显著的性能提升。 要将一个sync 的图实现转换为 async 的实现,您需要执行以下操作:
- 更新
nodes使用async def而不是def。 - 更新代码内部以适当使用
await。 - 根据需要使用
.ainvoke或.astream调用图。
async 种所有 sync 方法的变体,因此将一个 sync 图升级为 async 图通常相当快速。
下方是示例。为了演示底层 LLM 的异步调用,我们将包含一个对话模型:
- OpenAI
- Anthropic
- Azure
- Google Gemini
- AWS Bedrock
- HuggingFace
- OpenRouter
结合控制流和状态更新与 Command
将控制流(边)和状态更新(节点)结合起来可能很有用。例如,你可能希望在同一个节点中同时执行状态更新并决定下一步要前往哪个节点。LangGraph 通过从节点函数返回一个 @[Command] 对象提供了一种实现方式:
:::python
StateGraph]。请注意,这个图没有 用于路由的条件边!这是因为控制流是在 node_a 内部使用 @[Command] 定义的。
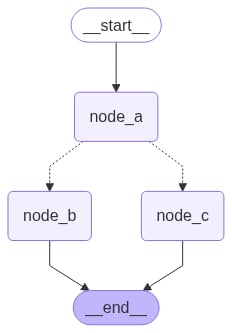
StateGraph。请注意,这个图没有 用于路由的条件边!这是因为控制流是在 Command 内部使用 nodeA 定义的。
在父图导航至节点
如果你在使用 子图,你可能需要从子图内的一个节点导航到不同的子图(即父图中的不同节点)。为此,你可以在Command 中指定 graph=Command.PARENT:
:::python
nodeA 更改为一个单节点图,并将其作为子图添加到我们的父图中来实现。
:::python
在工具内部使用
一个常见的用例是从工具内部更新图状态。例如,在客户支持应用程序中,您可能希望在对话开始时根据客户的账户号或ID查找客户信息。要从工具更新图状态,您可以从工具返回Command(update={"my_custom_key": "foo", "messages": [...]}):
:::python
Command] 更新状态的工具,我们建议使用预构建的 @[ToolNode],它自动处理返回 @[Command] 对象的工具并将它们传播到图状态。如果您正在编写一个调用工具的自定义节点,您需要手动将工具返回的 @[Command] 对象作为节点的更新进行传播。
可视化你的图
这里我们展示了如何可视化你创建的图。 你可以可视化任何任意的 图,包括 @[StateGraph]。
:::python
让我们通过绘制分形图案来玩点有趣的东西 :).
Mermaid
我们也可以将图类转换为 Mermaid 语法。 :::pythonPNG
:::python 如果需要,我们可以将图渲染为.png。这里我们可以使用三种选项:
- 使用 Mermaid.ink API(不需要额外的包)
- 使用 Mermaid + Pyppeteer(需要
pip install pyppeteer) - 使用 graphviz(这需要
pip install graphviz)
draw_mermaid_png() 使用 Mermaid.Ink 的 API 来生成图表。
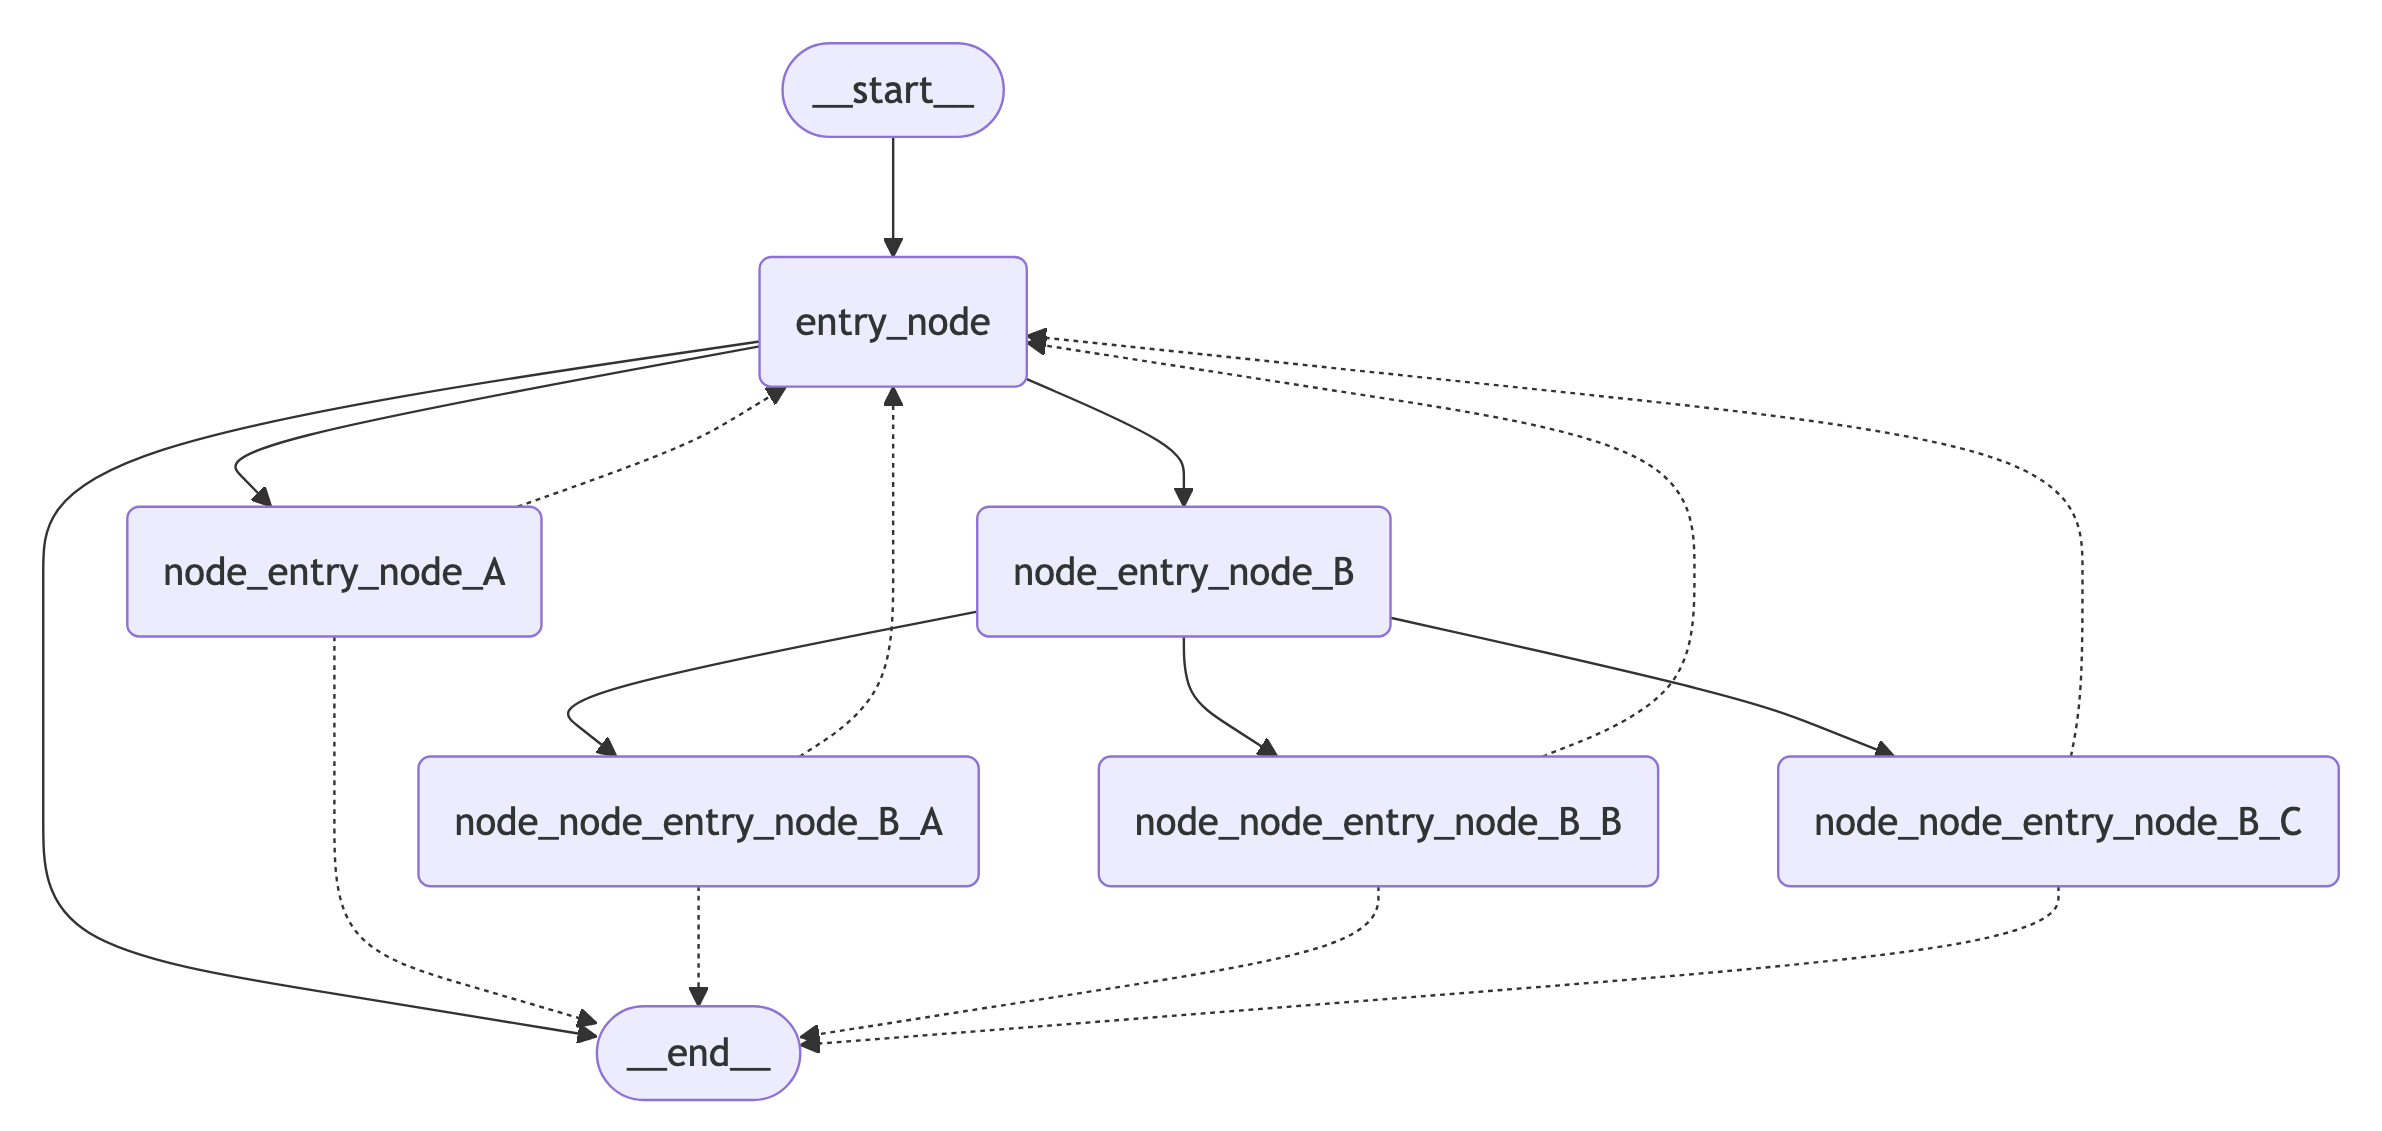
.png。这使用 Mermaid.ink API 来生成图表。
官方原文:src/oss/langgraph/use-graph-api.mdx · 非官方翻译,译文由 AI 生成,以英文原文为准。