添加短期能力
短期能力(线程级持久化)使智能体能跟踪多轮对话。添加短期能力的步骤如下: :::pythonfrom langgraph.checkpoint.memory import InMemorySaver
from langgraph.graph import StateGraph
checkpointer = InMemorySaver()
builder = StateGraph(...)
graph = builder.compile(checkpointer=checkpointer)
graph.invoke(
{"messages": [{"role": "user", "content": "hi! i am Bob"}]},
{"configurable": {"thread_id": "1"}},
)
import { MemorySaver, StateGraph } from "@langchain/langgraph";

const checkpointer = new MemorySaver();

const builder = new StateGraph(...);
const graph = builder.compile({ checkpointer });

await graph.invoke(
  { messages: [{ role: "user", content: "hi! i am Bob" }] },
  { configurable: { thread_id: "1" } }
);
生产环境使用
在生产环境中,使用基于数据库的检查点器: :::pythonfrom langgraph.checkpoint.postgres import PostgresSaver
DB_URI = "postgresql://postgres:postgres@localhost:5432/postgres?sslmode=disable"
with PostgresSaver.from_conn_string(DB_URI) as checkpointer:
builder = StateGraph(...)
graph = builder.compile(checkpointer=checkpointer)
- Postgres
- MongoDB
import { PostgresSaver } from "@langchain/langgraph-checkpoint-postgres";

const DB_URI = "postgresql://postgres:postgres@localhost:5432/postgres?sslmode=disable";
const checkpointer = PostgresSaver.fromConnString(DB_URI);

const builder = new StateGraph(...);
const graph = builder.compile({ checkpointer });
import { MongoClient } from "mongodb";
import { MongoDBSaver } from "@langchain/langgraph-checkpoint-mongodb";

const client = new MongoClient("mongodb://user:password@localhost:27017");
const checkpointer = new MongoDBSaver({ client });

const builder = new StateGraph(...);
const graph = builder.compile({ checkpointer });
Example: using Postgres checkpointer
Example: using Postgres checkpointer
:::python::::::js:::
pip install -U "psycopg[binary,pool]" langgraph langgraph-checkpoint-postgres
您首次使用PostgreSQL检查点器时需要调用
checkpointer.setup()- Sync
- Async
from langchain.chat_models import init_chat_model
from langgraph.graph import StateGraph, MessagesState, START
from langgraph.checkpoint.postgres import PostgresSaver

model = init_chat_model(model="claude-haiku-4-5-20251001")

DB_URI = "postgresql://postgres:postgres@localhost:5432/postgres?sslmode=disable"
with PostgresSaver.from_conn_string(DB_URI) as checkpointer:
    # checkpointer.setup()

    def call_model(state: MessagesState):
        response = model.invoke(state["messages"])
        return {"messages": response}

    builder = StateGraph(MessagesState)
    builder.add_node(call_model)
    builder.add_edge(START, "call_model")

    graph = builder.compile(checkpointer=checkpointer)

    config = {
        "configurable": {
            "thread_id": "1"
        }
    }

    stream = graph.stream_events(
        {"messages": [{"role": "user", "content": "hi! I'm bob"}]},
        config,
        version="v3",
    )
    for snapshot in stream.values:
        print(snapshot)

    stream = graph.stream_events(
        {"messages": [{"role": "user", "content": "what's my name?"}]},
        config,
        version="v3",
    )
    for snapshot in stream.values:
        print(snapshot)
from langchain.chat_models import init_chat_model
from langgraph.graph import StateGraph, MessagesState, START
from langgraph.checkpoint.postgres.aio import AsyncPostgresSaver

model = init_chat_model(model="claude-haiku-4-5-20251001")

DB_URI = "postgresql://postgres:postgres@localhost:5432/postgres?sslmode=disable"
async with AsyncPostgresSaver.from_conn_string(DB_URI) as checkpointer:
    # await checkpointer.setup()

    async def call_model(state: MessagesState):
        response = await model.ainvoke(state["messages"])
        return {"messages": response}

    builder = StateGraph(MessagesState)
    builder.add_node(call_model)
    builder.add_edge(START, "call_model")

    graph = builder.compile(checkpointer=checkpointer)

    config = {
        "configurable": {
            "thread_id": "1"
        }
    }

    stream = await graph.astream_events(
        {"messages": [{"role": "user", "content": "hi! I'm bob"}]},
        config,
        version="v3",
    )
    async for message in stream.messages:
        async for token in message.text:
            print(token, end="", flush=True)

    stream = await graph.astream_events(
        {"messages": [{"role": "user", "content": "what's my name?"}]},
        config,
        version="v3",
    )
    async for message in stream.messages:
        async for token in message.text:
            print(token, end="", flush=True)
npm install @langchain/langgraph-checkpoint-postgres
您首次使用PostgreSQL检查点器时需要调用
checkpointer.setup()import { ChatAnthropic } from "@langchain/anthropic";
import { StateGraph, StateSchema, MessagesValue, GraphNode, START } from "@langchain/langgraph";
import { PostgresSaver } from "@langchain/langgraph-checkpoint-postgres";
const State = new StateSchema({
messages: MessagesValue,
});
const model = new ChatAnthropic({ model: "claude-haiku-4-5-20251001" });
const DB_URI = "postgresql://postgres:postgres@localhost:5432/postgres?sslmode=disable";
const checkpointer = PostgresSaver.fromConnString(DB_URI);
// await checkpointer.setup();
const callModel: GraphNode<typeof State> = async (state) => {
const response = await model.invoke(state.messages);
return { messages: [response] };
};
const builder = new StateGraph(State)
.addNode("call_model", callModel)
.addEdge(START, "call_model");
const graph = builder.compile({ checkpointer });
const config = {
configurable: {
thread_id: "1"
}
};
const stream1 = await graph.streamEvents(
{ messages: [{ role: "user", content: "hi! I'm bob" }] },
{ ...config, version: "v3" }
);
for await (const snapshot of stream1.values) {
console.log(snapshot);
}
const stream2 = await graph.streamEvents(
{ messages: [{ role: "user", content: "what's my name?" }] },
{ ...config, version: "v3" }
);
for await (const snapshot of stream2.values) {
console.log(snapshot);
}
Example: using MongoDB checkpointer
Example: using MongoDB checkpointer
:::python::::::js:::
pip install -U pymongo langgraph langgraph-checkpoint-mongodb
配置
要使用 MongoDB检查点器,您需要MongoDB集群。若尚未创建,请参考 此指南。针对智能体的详细配置,请查看 使用MongoDB Atlas配置短期能力。
- Sync
- Async
from langchain.chat_models import init_chat_model
from langgraph.graph import StateGraph, MessagesState, START
from langgraph.checkpoint.mongodb import MongoDBSaver

model = init_chat_model(model="claude-haiku-4-5-20251001")

MONGODB_URI = "localhost:27017"
with MongoDBSaver.from_conn_string(MONGODB_URI) as checkpointer:

    def call_model(state: MessagesState):
        response = model.invoke(state["messages"])
        return {"messages": response}

    builder = StateGraph(MessagesState)
    builder.add_node(call_model)
    builder.add_edge(START, "call_model")

    graph = builder.compile(checkpointer=checkpointer)

    config = {
        "configurable": {
            "thread_id": "1"
        }
    }

    stream = graph.stream_events(
        {"messages": [{"role": "user", "content": "hi! I'm bob"}]},
        config,
        version="v3",
    )
    for snapshot in stream.values:
        print(snapshot)

    stream = graph.stream_events(
        {"messages": [{"role": "user", "content": "what's my name?"}]},
        config,
        version="v3",
    )
    for snapshot in stream.values:
        print(snapshot)
from langchain.chat_models import init_chat_model
from langgraph.graph import StateGraph, MessagesState, START
from langgraph.checkpoint.mongodb.aio import AsyncMongoDBSaver

model = init_chat_model(model="claude-haiku-4-5-20251001")

MONGODB_URI = "localhost:27017"
async with AsyncMongoDBSaver.from_conn_string(MONGODB_URI) as checkpointer:

    async def call_model(state: MessagesState):
        response = await model.ainvoke(state["messages"])
        return {"messages": response}

    builder = StateGraph(MessagesState)
    builder.add_node(call_model)
    builder.add_edge(START, "call_model")

    graph = builder.compile(checkpointer=checkpointer)

    config = {
        "configurable": {
            "thread_id": "1"
        }
    }

    stream = await graph.astream_events(
        {"messages": [{"role": "user", "content": "hi! I'm bob"}]},
        config,
        version="v3",
    )
    async for message in stream.messages:
        async for token in message.text:
            print(token, end="", flush=True)

    stream = await graph.astream_events(
        {"messages": [{"role": "user", "content": "what's my name?"}]},
        config,
        version="v3",
    )
    async for message in stream.messages:
        async for token in message.text:
            print(token, end="", flush=True)
npm install @langchain/langgraph-checkpoint-mongodb
设置
要使用
MongoDBSaver,您需要一个 MongoDB 集群。如果您还没有集群,请按照 此指南 创建一个。有关以智能体为中心的逐步说明,请参阅 使用 MongoDB Atlas 的短期记忆。import { ChatAnthropic } from "@langchain/anthropic";
import { StateGraph, StateSchema, MessagesValue, GraphNode, START } from "@langchain/langgraph";
import { MongoDBSaver } from "@langchain/langgraph-checkpoint-mongodb";
import { MongoClient } from "mongodb";
const State = new StateSchema({
messages: MessagesValue,
});
const model = new ChatAnthropic({ model: "claude-haiku-4-5-20251001" });
const client = new MongoClient("mongodb://user:password@localhost:27017");
const checkpointer = new MongoDBSaver({ client, dbName: "langgraph" });
const callModel: GraphNode<typeof State> = async (state) => {
const response = await model.invoke(state.messages);
return { messages: [response] };
};
const builder = new StateGraph(State)
.addNode("call_model", callModel)
.addEdge(START, "call_model");
const graph = builder.compile({ checkpointer });
const config = { configurable: { thread_id: "1" } };
const stream1 = await graph.streamEvents(
{ messages: [{ role: "user", content: "hi! I'm bob" }] },
{ ...config, version: "v3" }
);
for await (const snapshot of stream1.values) {
console.log(snapshot);
}
const stream2 = await graph.streamEvents(
{ messages: [{ role: "user", content: "what's my name?" }] },
{ ...config, version: "v3" }
);
for await (const snapshot of stream2.values) {
console.log(snapshot);
}
Example: using Redis checkpointer
Example: using Redis checkpointer
pip install -U langgraph langgraph-checkpoint-redis
你在使用 Redis 检查点器时,第一次需要调用
checkpointer.setup()。- Sync
- Async
from langchain.chat_models import init_chat_model
from langgraph.graph import StateGraph, MessagesState, START
from langgraph.checkpoint.redis import RedisSaver

model = init_chat_model(model="claude-haiku-4-5-20251001")

DB_URI = "redis://localhost:6379"
with RedisSaver.from_conn_string(DB_URI) as checkpointer:
    # checkpointer.setup()

    def call_model(state: MessagesState):
        response = model.invoke(state["messages"])
        return {"messages": response}

    builder = StateGraph(MessagesState)
    builder.add_node(call_model)
    builder.add_edge(START, "call_model")

    graph = builder.compile(checkpointer=checkpointer)

    config = {
        "configurable": {
            "thread_id": "1"
        }
    }

    stream = graph.stream_events(
        {"messages": [{"role": "user", "content": "hi! I'm bob"}]},
        config,
        version="v3",
    )
    for snapshot in stream.values:
        print(snapshot)

    stream = graph.stream_events(
        {"messages": [{"role": "user", "content": "what's my name?"}]},
        config,
        version="v3",
    )
    for snapshot in stream.values:
        print(snapshot)
from langchain.chat_models import init_chat_model
from langgraph.graph import StateGraph, MessagesState, START
from langgraph.checkpoint.redis.aio import AsyncRedisSaver

model = init_chat_model(model="claude-haiku-4-5-20251001")

DB_URI = "redis://localhost:6379"
async with AsyncRedisSaver.from_conn_string(DB_URI) as checkpointer:
    # await checkpointer.asetup()

    async def call_model(state: MessagesState):
        response = await model.ainvoke(state["messages"])
        return {"messages": response}

    builder = StateGraph(MessagesState)
    builder.add_node(call_model)
    builder.add_edge(START, "call_model")

    graph = builder.compile(checkpointer=checkpointer)

    config = {
        "configurable": {
            "thread_id": "1"
        }
    }

    stream = await graph.astream_events(
        {"messages": [{"role": "user", "content": "hi! I'm bob"}]},
        config,
        version="v3",
    )
    async for message in stream.messages:
        async for token in message.text:
            print(token, end="", flush=True)

    stream = await graph.astream_events(
        {"messages": [{"role": "user", "content": "what's my name?"}]},
        config,
        version="v3",
    )
    async for message in stream.messages:
        async for token in message.text:
            print(token, end="", flush=True)
Example: using Oracle checkpointer
Example: using Oracle checkpointer
pip install -U langgraph langgraph-oracledb
设置
要使用 Oracle 检查点器,您需要一个 Oracle AI 数据库实例。本地容器(例如
gvenzl/oracle-free:23-slim)或 OCI 中的 Oracle 自主数据库均可。你在使用 Oracle 检查点器时,第一次需要调用
checkpointer.setup()。- Sync
- Async
from langchain.chat_models import init_chat_model
from langgraph.graph import StateGraph, MessagesState, START
from langgraph_oracledb.checkpoint.oracle import OracleSaver

model = init_chat_model(model="claude-haiku-4-5-20251001")

DB_URI = "user/password@localhost:1521/FREEPDB1"
with OracleSaver.from_conn_string(DB_URI) as checkpointer:
    # checkpointer.setup()

    def call_model(state: MessagesState):
        response = model.invoke(state["messages"])
        return {"messages": response}

    builder = StateGraph(MessagesState)
    builder.add_node(call_model)
    builder.add_edge(START, "call_model")

    graph = builder.compile(checkpointer=checkpointer)

    config = {
        "configurable": {
            "thread_id": "1"
        }
    }

    stream = graph.stream_events(
        {"messages": [{"role": "user", "content": "hi! I'm bob"}]},
        config,
        version="v3",
    )
    for snapshot in stream.values:
        print(snapshot)

    stream = graph.stream_events(
        {"messages": [{"role": "user", "content": "what's my name?"}]},
        config,
        version="v3",
    )
    for snapshot in stream.values:
        print(snapshot)
from langchain.chat_models import init_chat_model
from langgraph.graph import StateGraph, MessagesState, START
from langgraph_oracledb.checkpoint.oracle import AsyncOracleSaver

model = init_chat_model(model="claude-haiku-4-5-20251001")

DB_URI = "user/password@localhost:1521/FREEPDB1"
async with AsyncOracleSaver.from_conn_string(DB_URI) as checkpointer:
    # await checkpointer.setup()

    async def call_model(state: MessagesState):
        response = await model.ainvoke(state["messages"])
        return {"messages": response}

    builder = StateGraph(MessagesState)
    builder.add_node(call_model)
    builder.add_edge(START, "call_model")

    graph = builder.compile(checkpointer=checkpointer)

    config = {
        "configurable": {
            "thread_id": "1"
        }
    }

    stream = await graph.astream_events(
        {"messages": [{"role": "user", "content": "hi! I'm bob"}]},
        config,
        version="v3",
    )
    async for message in stream.messages:
        async for token in message.text:
            print(token, end="", flush=True)

    stream = await graph.astream_events(
        {"messages": [{"role": "user", "content": "what's my name?"}]},
        config,
        version="v3",
    )
    async for message in stream.messages:
        async for token in message.text:
            print(token, end="", flush=True)
在子图中使用
如果你的图包含 子图,你只需要在编译父图时提供检查点器。LangGraph 将自动将检查点器传播到子子图。 :::pythonfrom langgraph.graph import START, StateGraph
from langgraph.checkpoint.memory import InMemorySaver
from typing import TypedDict
class State(TypedDict):
foo: str
# Subgraph
def subgraph_node_1(state: State):
return {"foo": state["foo"] + "bar"}
subgraph_builder = StateGraph(State)
subgraph_builder.add_node(subgraph_node_1)
subgraph_builder.add_edge(START, "subgraph_node_1")
subgraph = subgraph_builder.compile()
# Parent graph
builder = StateGraph(State)
builder.add_node("node_1", subgraph)
builder.add_edge(START, "node_1")
checkpointer = InMemorySaver()
graph = builder.compile(checkpointer=checkpointer)
import { StateGraph, StateSchema, START, MemorySaver } from "@langchain/langgraph";
import { z } from "zod/v4";

const State = new StateSchema({ foo: z.string() });

const subgraphBuilder = new StateGraph(State)
  .addNode("subgraph_node_1", (state) => {
    return { foo: state.foo + "bar" };
  })
  .addEdge(START, "subgraph_node_1");
const subgraph = subgraphBuilder.compile();

const builder = new StateGraph(State)
  .addNode("node_1", subgraph)
  .addEdge(START, "node_1");

const checkpointer = new MemorySaver();
const graph = builder.compile({ checkpointer });
subgraph_builder = StateGraph(...)
subgraph = subgraph_builder.compile(checkpointer=True)
const subgraphBuilder = new StateGraph(...);
const subgraph = subgraphBuilder.compile({ checkpointer: true });
添加长期记忆
使用长期记忆来存储跨对话的用户特定或应用特定的数据。 :::pythonfrom langgraph.store.memory import InMemoryStore
from langgraph.graph import StateGraph
store = InMemoryStore()
builder = StateGraph(...)
graph = builder.compile(store=store)
import { InMemoryStore, StateGraph } from "@langchain/langgraph";

const store = new InMemoryStore();

const builder = new StateGraph(...);
const graph = builder.compile({ store });
在节点内访问存储
一旦你编译一个包含存储的图,LangGraph 会自动将存储注入到你的节点函数中。推荐通过Runtime 对象访问存储。
:::python
from dataclasses import dataclass
from langgraph.runtime import Runtime
from langgraph.graph import StateGraph, MessagesState, START
from langchain_core.utils.uuid import uuid7
@dataclass
class Context:
    user_id: str

async def call_model(state: MessagesState, runtime: Runtime[Context]):
    user_id = runtime.context.user_id
    namespace = (user_id, "memories")

    # Search for relevant memories
    memories = await runtime.store.asearch(
        namespace, query=state["messages"][-1].content, limit=3
    )
    info = "\n".join([d.value["data"] for d in memories])

    # ... Use memories in model call

    # Store a new memory
    await runtime.store.aput(
        namespace, str(uuid7()), {"data": "User prefers dark mode"}
    )

builder = StateGraph(MessagesState, context_schema=Context)
builder.add_node(call_model)
builder.add_edge(START, "call_model")
graph = builder.compile(store=store)

# Pass context at invocation time
graph.invoke(
    {"messages": [{"role": "user", "content": "hi"}]},
    {"configurable": {"thread_id": "1"}},
    context=Context(user_id="1"),
)
import { StateGraph, StateSchema, MessagesValue, GraphNode, START } from "@langchain/langgraph";
import { v7 as uuid7 } from "uuid";

const State = new StateSchema({
  messages: MessagesValue,
});

const callModel: GraphNode<typeof State> = async (state, runtime) => {
  const userId = runtime.context?.userId;
  const namespace = [userId, "memories"];

  // Search for relevant memories
  const memories = await runtime.store?.search(namespace, {
    query: state.messages.at(-1)?.content,
    limit: 3,
  });
  const info = memories?.map((d) => d.value.data).join("\n") || "";

  // ... Use memories in model call

  // Store a new memory
  await runtime.store?.put(namespace, uuid7(), { data: "User prefers dark mode" });
};

const builder = new StateGraph(State)
  .addNode("call_model", callModel)
  .addEdge(START, "call_model");
const graph = builder.compile({ store });

// Pass context at invocation time
await graph.invoke(
  { messages: [{ role: "user", content: "hi" }] },
  { configurable: { thread_id: "1" }, context: { userId: "1" } }
);
用于生产环境
在生产环境中,使用基于数据库的存储: :::pythonfrom langgraph.store.postgres import PostgresStore
DB_URI = "postgresql://postgres:postgres@localhost:5432/postgres?sslmode=disable"
with PostgresStore.from_conn_string(DB_URI) as store:
builder = StateGraph(...)
graph = builder.compile(store=store)
- Postgres
- MongoDB
import { PostgresStore } from "@langchain/langgraph-checkpoint-postgres/store";

const DB_URI = "postgresql://postgres:postgres@localhost:5432/postgres?sslmode=disable";
const store = PostgresStore.fromConnString(DB_URI);

const builder = new StateGraph(...);
const graph = builder.compile({ store });
import { MongoDBStore } from "@langchain/langgraph-checkpoint-mongodb";

const MONGODB_URI = "mongodb://user:password@localhost:27017";
const store = await MongoDBStore.fromConnString(MONGODB_URI, {
  dbName: "langgraph",
  collectionName: "store",
});

const builder = new StateGraph(...);
const graph = builder.compile({ store });
Example: using Postgres store
Example: using Postgres store
:::python::::::js:::
pip install -U "psycopg[binary,pool]" langgraph langgraph-checkpoint-postgres
你在使用 Postgres store 时,第一次需要调用
store.setup()- Async
- Sync
from dataclasses import dataclass
from langchain.chat_models import init_chat_model
from langgraph.graph import StateGraph, MessagesState, START
from langgraph.checkpoint.postgres.aio import AsyncPostgresSaver
from langgraph.store.postgres.aio import AsyncPostgresStore
from langgraph.runtime import Runtime

model = init_chat_model(model="claude-haiku-4-5-20251001")

@dataclass
class Context:
    user_id: str

async def call_model(
    state: MessagesState,
    runtime: Runtime[Context],
):
    user_id = runtime.context.user_id
    namespace = ("memories", user_id)
    memories = await runtime.store.asearch(namespace, query=str(state["messages"][-1].content))
    info = "\n".join([d.value["data"] for d in memories])
    system_msg = f"You are a helpful assistant talking to the user. User info: {info}"

    # Store new memories if the user asks the model to remember
    last_message = state["messages"][-1]
    if "remember" in last_message.content.lower():
        memory = "User name is Bob"
        await runtime.store.aput(namespace, str(uuid7()), {"data": memory})

    response = await model.ainvoke(
        [{"role": "system", "content": system_msg}] + state["messages"]
    )
    return {"messages": response}

DB_URI = "postgresql://postgres:postgres@localhost:5432/postgres?sslmode=disable"

async with (
    AsyncPostgresStore.from_conn_string(DB_URI) as store,
    AsyncPostgresSaver.from_conn_string(DB_URI) as checkpointer,
):
    # await store.setup()
    # await checkpointer.setup()

    builder = StateGraph(MessagesState, context_schema=Context)
    builder.add_node(call_model)
    builder.add_edge(START, "call_model")

    graph = builder.compile(
        checkpointer=checkpointer,
        store=store,
    )

    config = {"configurable": {"thread_id": "1"}}
    stream = await graph.astream_events(
        {"messages": [{"role": "user", "content": "Hi! Remember: my name is Bob"}]},
        config,
        version="v3",
        context=Context(user_id="1"),
    )
    async for message in stream.messages:
        async for token in message.text:
            print(token, end="", flush=True)

    config = {"configurable": {"thread_id": "2"}}
    stream = await graph.astream_events(
        {"messages": [{"role": "user", "content": "what is my name?"}]},
        config,
        version="v3",
        context=Context(user_id="1"),
    )
    async for message in stream.messages:
        async for token in message.text:
            print(token, end="", flush=True)
from dataclasses import dataclass
from langchain.chat_models import init_chat_model
from langgraph.graph import StateGraph, MessagesState, START
from langgraph.checkpoint.postgres import PostgresSaver
from langgraph.store.postgres import PostgresStore
from langgraph.runtime import Runtime

model = init_chat_model(model="claude-haiku-4-5-20251001")

@dataclass
class Context:
    user_id: str

def call_model(
    state: MessagesState,
    runtime: Runtime[Context],
):
    user_id = runtime.context.user_id
    namespace = ("memories", user_id)
    memories = runtime.store.search(namespace, query=str(state["messages"][-1].content))
    info = "\n".join([d.value["data"] for d in memories])
    system_msg = f"You are a helpful assistant talking to the user. User info: {info}"

    # Store new memories if the user asks the model to remember
    last_message = state["messages"][-1]
    if "remember" in last_message.content.lower():
        memory = "User name is Bob"
        runtime.store.put(namespace, str(uuid7()), {"data": memory})

    response = model.invoke(
        [{"role": "system", "content": system_msg}] + state["messages"]
    )
    return {"messages": response}

DB_URI = "postgresql://postgres:postgres@localhost:5432/postgres?sslmode=disable"

with (
    PostgresStore.from_conn_string(DB_URI) as store,
    PostgresSaver.from_conn_string(DB_URI) as checkpointer,
):
    # store.setup()
    # checkpointer.setup()

    builder = StateGraph(MessagesState, context_schema=Context)
    builder.add_node(call_model)
    builder.add_edge(START, "call_model")

    graph = builder.compile(
        checkpointer=checkpointer,
        store=store,
    )

    config = {"configurable": {"thread_id": "1"}}
    stream = graph.stream_events(
        {"messages": [{"role": "user", "content": "Hi! Remember: my name is Bob"}]},
        config,
        version="v3",
        context=Context(user_id="1"),
    )
    for snapshot in stream.values:
        print(snapshot)

    config = {"configurable": {"thread_id": "2"}}
    stream = graph.stream_events(
        {"messages": [{"role": "user", "content": "what is my name?"}]},
        config,
        version="v3",
        context=Context(user_id="1"),
    )
    for snapshot in stream.values:
        print(snapshot)
npm install @langchain/langgraph-checkpoint-postgres
你在使用 Postgres store 时,第一次需要调用
store.setup()import { ChatAnthropic } from "@langchain/anthropic";
import { StateGraph, StateSchema, MessagesValue, GraphNode, START } from "@langchain/langgraph";
import { PostgresSaver } from "@langchain/langgraph-checkpoint-postgres";
import { PostgresStore } from "@langchain/langgraph-checkpoint-postgres/store";
import { v7 as uuid7 } from "uuid";
const State = new StateSchema({
messages: MessagesValue,
});
const model = new ChatAnthropic({ model: "claude-haiku-4-5-20251001" });
const callModel: GraphNode<typeof State> = async (state, runtime) => {
const userId = runtime.context?.userId;
const namespace = ["memories", userId];
const memories = await runtime.store?.search(namespace, { query: state.messages.at(-1)?.content });
const info = memories?.map(d => d.value.data).join("\n") || "";
const systemMsg = `You are a helpful assistant talking to the user. User info: ${info}`;
// Store new memories if the user asks the model to remember
const lastMessage = state.messages.at(-1);
if (lastMessage?.content?.toLowerCase().includes("remember")) {
const memory = "User name is Bob";
await runtime.store?.put(namespace, uuid7(), { data: memory });
}
const response = await model.invoke([
{ role: "system", content: systemMsg },
...state.messages
]);
return { messages: [response] };
};
const DB_URI = "postgresql://postgres:postgres@localhost:5432/postgres?sslmode=disable";
const store = PostgresStore.fromConnString(DB_URI);
const checkpointer = PostgresSaver.fromConnString(DB_URI);
// await store.setup();
// await checkpointer.setup();
const builder = new StateGraph(State)
.addNode("call_model", callModel)
.addEdge(START, "call_model");
const graph = builder.compile({
checkpointer,
store,
});
const stream1 = await graph.streamEvents(
{ messages: [{ role: "user", content: "Hi! Remember: my name is Bob" }] },
{ configurable: { thread_id: "1" }, context: { userId: "1" }, version: "v3" }
);
for await (const snapshot of stream1.values) {
console.log(snapshot);
}
const stream2 = await graph.streamEvents(
{ messages: [{ role: "user", content: "what is my name?" }] },
{ configurable: { thread_id: "2" }, context: { userId: "1" }, version: "v3" }
);
for await (const snapshot of stream2.values) {
console.log(snapshot);
}
Example: using MongoDB store
Example: using MongoDB store
:::python::::::js:::
pip install -U langgraph-store-mongodb langgraph-checkpoint-mongodb
基于
query的语义搜索需要 MongoDB 向量搜索($vectorSearch),该搜索在 MongoDB Atlas或具有搜索和向量搜索(mongot)的私有管理的 MongoDB 上运行。没有mongot的纯mongod是不够的。在打开存储时从create_vector_index_config传递index_config。索引创建可能超过默认的 15 秒等待时间,因此首次运行时将auto_index_timeout设置得更高。有关 Atlas 集群设置,请参阅此指南。有关向量索引设置和以智能体为中心的逐步介绍,请参阅使用 MongoDB Atlas 的长期记忆。- Async
- Sync
import os
from collections.abc import Sequence
from dataclasses import dataclass
from uuid import uuid4

from langchain.chat_models import init_chat_model
from langgraph.checkpoint.mongodb import MongoDBSaver
from langgraph.graph import StateGraph, MessagesState, START
from langgraph.runtime import Runtime
from langgraph.store.mongodb import MongoDBStore, create_vector_index_config

model = init_chat_model(model="claude-haiku-4-5-20251001")

def embed(texts: Sequence[str]) -> list[list[float]]:
    # Replace with an embeddings model or LangChain Embeddings instance
    return [[1.0, 2.0] for _ in texts]

@dataclass
class Context:
    user_id: str

async def call_model(
    state: MessagesState,
    runtime: Runtime[Context],
):
    user_id = runtime.context.user_id
    namespace = ("memories", user_id)
    memories = await runtime.store.asearch(namespace, query=str(state["messages"][-1].content))
    info = "\n".join([d.value["data"] for d in memories])
    system_msg = f"You are a helpful assistant talking to the user. User info: {info}"

    # Store new memories if the user asks the model to remember
    last_message = state["messages"][-1]
    if "remember" in last_message.content.lower():
        memory = "User name is Bob"
        await runtime.store.aput(namespace, str(uuid4()), {"data": memory})

    response = await model.ainvoke(
        [{"role": "system", "content": system_msg}] + state["messages"]
    )
    return {"messages": response}

MONGODB_ATLAS_URI = os.environ["MONGODB_ATLAS_URI"]
index_config = create_vector_index_config(embed=embed, dims=2, fields=["data"])

with (
    MongoDBStore.from_conn_string(
        MONGODB_ATLAS_URI,
        index_config=index_config,
        auto_index_timeout=120,
    ) as store,
    MongoDBSaver.from_conn_string(MONGODB_ATLAS_URI) as checkpointer,
):
    builder = StateGraph(MessagesState, context_schema=Context)
    builder.add_node(call_model)
    builder.add_edge(START, "call_model")

    graph = builder.compile(
        checkpointer=checkpointer,
        store=store,
    )

    import asyncio

    async def run():
        config = {"configurable": {"thread_id": "1"}}
        stream = await graph.astream_events(
            {"messages": [{"role": "user", "content": "Hi! Remember: my name is Bob"}]},
            config,
            version="v3",
            context=Context(user_id="1"),
        )
        async for snapshot in stream.values:
            snapshot["messages"][-1].pretty_print()

        config = {"configurable": {"thread_id": "2"}}
        stream = await graph.astream_events(
            {"messages": [{"role": "user", "content": "what is my name?"}]},
            config,
            version="v3",
            context=Context(user_id="1"),
        )
        async for snapshot in stream.values:
            snapshot["messages"][-1].pretty_print()

    asyncio.run(run())
import os
from collections.abc import Sequence
from dataclasses import dataclass
from uuid import uuid4

from langchain.chat_models import init_chat_model
from langgraph.checkpoint.mongodb import MongoDBSaver
from langgraph.graph import StateGraph, MessagesState, START
from langgraph.runtime import Runtime
from langgraph.store.mongodb import MongoDBStore, create_vector_index_config

model = init_chat_model(model="claude-haiku-4-5-20251001")

def embed(texts: Sequence[str]) -> list[list[float]]:
    # Replace with an embeddings model or LangChain Embeddings instance
    return [[1.0, 2.0] for _ in texts]

@dataclass
class Context:
    user_id: str

def call_model(
    state: MessagesState,
    runtime: Runtime[Context],
):
    user_id = runtime.context.user_id
    namespace = ("memories", user_id)
    memories = runtime.store.search(namespace, query=str(state["messages"][-1].content))
    info = "\n".join([d.value["data"] for d in memories])
    system_msg = f"You are a helpful assistant talking to the user. User info: {info}"

    # Store new memories if the user asks the model to remember
    last_message = state["messages"][-1]
    if "remember" in last_message.content.lower():
        memory = "User name is Bob"
        runtime.store.put(namespace, str(uuid4()), {"data": memory})

    response = model.invoke(
        [{"role": "system", "content": system_msg}] + state["messages"]
    )
    return {"messages": response}

MONGODB_ATLAS_URI = os.environ["MONGODB_ATLAS_URI"]
index_config = create_vector_index_config(embed=embed, dims=2, fields=["data"])

with (
    MongoDBStore.from_conn_string(
        MONGODB_ATLAS_URI,
        index_config=index_config,
        auto_index_timeout=120,
    ) as store,
    MongoDBSaver.from_conn_string(MONGODB_ATLAS_URI) as checkpointer,
):
    builder = StateGraph(MessagesState, context_schema=Context)
    builder.add_node(call_model)
    builder.add_edge(START, "call_model")

    graph = builder.compile(
        checkpointer=checkpointer,
        store=store,
    )

    config = {"configurable": {"thread_id": "1"}}
    stream = graph.stream_events(
        {"messages": [{"role": "user", "content": "Hi! Remember: my name is Bob"}]},
        config,
        version="v3",
        context=Context(user_id="1"),
    )
    for snapshot in stream.values:
        snapshot["messages"][-1].pretty_print()

    config = {"configurable": {"thread_id": "2"}}
    stream = graph.stream_events(
        {"messages": [{"role": "user", "content": "what is my name?"}]},
        config,
        version="v3",
        context=Context(user_id="1"),
    )
    for snapshot in stream.values:
        snapshot["messages"][-1].pretty_print()
npm install @langchain/langgraph-checkpoint-mongodb
想要了解以智能体为中心的介绍,请参阅 使用 MongoDB Atlas 的长期记忆。
import { ChatAnthropic } from "@langchain/anthropic";
import { MemorySaver, StateGraph, StateSchema, MessagesValue, GraphNode, START } from "@langchain/langgraph";
import { MongoDBStore } from "@langchain/langgraph-checkpoint-mongodb";

import { v7 as uuid7 } from "uuid";
const State = new StateSchema({
  messages: MessagesValue,
});

const model = new ChatAnthropic({ model: "claude-sonnet-4-6" });

const callModel: GraphNode<typeof State> = async (state, runtime) => {
  const userId = runtime.context?.userId;
  const namespace = ["memories", userId];
  const memories = await runtime.store?.search(namespace);
  const info = memories?.map(d => d.value.data).join("\n") || "n/a";
  const systemMsg = `You are a helpful assistant talking to the user. User info: ${info}`;

  // Store new memories if the user asks the model to remember
  const lastMessage = state.messages.at(-1);
  if (lastMessage?.content?.toLowerCase().includes("remember")) {
    const memory = "User name is Bob";
    await runtime.store?.put(namespace, uuid7(), { data: memory });
  }

  const response = await model.invoke([
    { role: "system", content: systemMsg },
    ...state.messages
  ]);
  return { messages: [response] };
};

const MONGODB_URI = "mongodb://user:password@localhost:27017";

const store = await MongoDBStore.fromConnString(MONGODB_URI, {
  dbName: "langgraph",
  collectionName: "store",
});

const checkpointer = new MemorySaver();

const builder = new StateGraph(State)
  .addNode("call_model", callModel)
  .addEdge(START, "call_model");

const graph = builder.compile({ checkpointer, store });

const stream1 = await graph.streamEvents(
  { messages: [{ role: "user", content: "Hi! Remember: my name is Bob" }] },
  { configurable: { thread_id: "1" }, context: { userId: "1" }, version: "v3" }
);
for await (const snapshot of stream1.values) {
  console.log(snapshot);
}

const stream2 = await graph.streamEvents(
  { messages: [{ role: "user", content: "what is my name?" }] },
  { configurable: { thread_id: "2" }, context: { userId: "1" }, version: "v3" }
);
for await (const snapshot of stream2.values) {
  console.log(snapshot);
}
Example: using Redis store
Example: using Redis store
pip install -U langgraph langgraph-checkpoint-redis
你在使用 Redis store 时,第一次需要调用
store.setup()。- Async
- Sync
from dataclasses import dataclass
from langchain.chat_models import init_chat_model
from langgraph.graph import StateGraph, MessagesState, START
from langgraph.checkpoint.redis.aio import AsyncRedisSaver
from langgraph.store.redis.aio import AsyncRedisStore
from langgraph.runtime import Runtime

model = init_chat_model(model="claude-haiku-4-5-20251001")

@dataclass
class Context:
    user_id: str

async def call_model(
    state: MessagesState,
    runtime: Runtime[Context],
):
    user_id = runtime.context.user_id
    namespace = ("memories", user_id)
    memories = await runtime.store.asearch(namespace, query=str(state["messages"][-1].content))
    info = "\n".join([d.value["data"] for d in memories])
    system_msg = f"You are a helpful assistant talking to the user. User info: {info}"

    # Store new memories if the user asks the model to remember
    last_message = state["messages"][-1]
    if "remember" in last_message.content.lower():
        memory = "User name is Bob"
        await runtime.store.aput(namespace, str(uuid7()), {"data": memory})

    response = await model.ainvoke(
        [{"role": "system", "content": system_msg}] + state["messages"]
    )
    return {"messages": response}

DB_URI = "redis://localhost:6379"

async with (
    AsyncRedisStore.from_conn_string(DB_URI) as store,
    AsyncRedisSaver.from_conn_string(DB_URI) as checkpointer,
):
    # await store.setup()
    # await checkpointer.asetup()

    builder = StateGraph(MessagesState, context_schema=Context)
    builder.add_node(call_model)
    builder.add_edge(START, "call_model")

    graph = builder.compile(
        checkpointer=checkpointer,
        store=store,
    )

    config = {"configurable": {"thread_id": "1"}}
    stream = await graph.astream_events(
        {"messages": [{"role": "user", "content": "Hi! Remember: my name is Bob"}]},
        config,
        version="v3",
        context=Context(user_id="1"),
    )
    async for snapshot in stream.values:
        snapshot["messages"][-1].pretty_print()

    config = {"configurable": {"thread_id": "2"}}
    stream = await graph.astream_events(
        {"messages": [{"role": "user", "content": "what is my name?"}]},
        config,
        version="v3",
        context=Context(user_id="1"),
    )
    async for snapshot in stream.values:
        snapshot["messages"][-1].pretty_print()
from dataclasses import dataclass
from langchain.chat_models import init_chat_model
from langgraph.graph import StateGraph, MessagesState, START
from langgraph.checkpoint.redis import RedisSaver
from langgraph.store.redis import RedisStore
from langgraph.runtime import Runtime

model = init_chat_model(model="claude-haiku-4-5-20251001")

@dataclass
class Context:
    user_id: str

def call_model(
    state: MessagesState,
    runtime: Runtime[Context],
):
    user_id = runtime.context.user_id
    namespace = ("memories", user_id)
    memories = runtime.store.search(namespace, query=str(state["messages"][-1].content))
    info = "\n".join([d.value["data"] for d in memories])
    system_msg = f"You are a helpful assistant talking to the user. User info: {info}"

    # Store new memories if the user asks the model to remember
    last_message = state["messages"][-1]
    if "remember" in last_message.content.lower():
        memory = "User name is Bob"
        runtime.store.put(namespace, str(uuid7()), {"data": memory})

    response = model.invoke(
        [{"role": "system", "content": system_msg}] + state["messages"]
    )
    return {"messages": response}

DB_URI = "redis://localhost:6379"

with (
    RedisStore.from_conn_string(DB_URI) as store,
    RedisSaver.from_conn_string(DB_URI) as checkpointer,
):
    store.setup()
    checkpointer.setup()

    builder = StateGraph(MessagesState, context_schema=Context)
    builder.add_node(call_model)
    builder.add_edge(START, "call_model")

    graph = builder.compile(
        checkpointer=checkpointer,
        store=store,
    )

    config = {"configurable": {"thread_id": "1"}}
    stream = graph.stream_events(
        {"messages": [{"role": "user", "content": "Hi! Remember: my name is Bob"}]},
        config,
        version="v3",
        context=Context(user_id="1"),
    )
    for snapshot in stream.values:
        snapshot["messages"][-1].pretty_print()

    config = {"configurable": {"thread_id": "2"}}
    stream = graph.stream_events(
        {"messages": [{"role": "user", "content": "what is my name?"}]},
        config,
        version="v3",
        context=Context(user_id="1"),
    )
    for snapshot in stream.values:
        snapshot["messages"][-1].pretty_print()
Example: using Oracle store
Example: using Oracle store
pip install -U langgraph langgraph-oracledb langchain-openai
设置
要使用 Oracle store,您需要一个 Oracle AI Database 实例——用于语义
search 的向量索引需要 Oracle AI Vector Search。你在使用 Oracle 存储和检查点器时,第一次需要调用
store.setup() 和 checkpointer.setup()。- Sync
- Async
from langchain.chat_models import init_chat_model
from langchain.embeddings import init_embeddings
from langchain_core.runnables import RunnableConfig
from langgraph.graph import StateGraph, MessagesState, START
from langgraph.store.base import BaseStore
from langgraph_oracledb.checkpoint.oracle import OracleSaver
from langgraph_oracledb.store.oracle import OracleStore

model = init_chat_model(model="claude-haiku-4-5-20251001")
embeddings = init_embeddings("openai:text-embedding-3-small")

DB_URI = "user/password@localhost:1521/FREEPDB1"

with (
    OracleStore.from_conn_string(
        DB_URI,
        index={"embed": embeddings, "dims": 1536},
    ) as store,
    OracleSaver.from_conn_string(DB_URI) as checkpointer,
):
    store.setup()
    checkpointer.setup()

    def call_model(
        state: MessagesState,
        config: RunnableConfig,
        *,
        store: BaseStore,
    ):
        user_id = config["configurable"]["user_id"]
        namespace = ("memories", user_id)
        memories = store.search(namespace, query=str(state["messages"][-1].content))
        info = "\n".join([d.value["data"] for d in memories])
        system_msg = f"You are a helpful assistant talking to the user. User info: {info}"

        # Store new memories if the user asks the model to remember
        last_message = state["messages"][-1]
        if "remember" in last_message.content.lower():
            memory = "User name is Bob"
            store.put(namespace, str(uuid7()), {"data": memory})

        response = model.invoke(
            [{"role": "system", "content": system_msg}] + state["messages"]
        )
        return {"messages": response}

    builder = StateGraph(MessagesState)
    builder.add_node(call_model)
    builder.add_edge(START, "call_model")

    graph = builder.compile(
        checkpointer=checkpointer,
        store=store,
    )

    config = {
        "configurable": {
            "thread_id": "1",
            "user_id": "1",
        }
    }
    stream = graph.stream_events(
        {"messages": [{"role": "user", "content": "Hi! Remember: my name is Bob"}]},
        config,
        version="v3",
    )
    for snapshot in stream.values:
        snapshot["messages"][-1].pretty_print()

    config = {
        "configurable": {
            "thread_id": "2",
            "user_id": "1",
        }
    }

    stream = graph.stream_events(
        {"messages": [{"role": "user", "content": "what is my name?"}]},
        config,
        version="v3",
    )
    for snapshot in stream.values:
        snapshot["messages"][-1].pretty_print()
from langchain.chat_models import init_chat_model
from langchain.embeddings import init_embeddings
from langchain_core.runnables import RunnableConfig
from langgraph.graph import StateGraph, MessagesState, START
from langgraph.store.base import BaseStore
from langgraph_oracledb.checkpoint.oracle import AsyncOracleSaver
from langgraph_oracledb.store.oracle import AsyncOracleStore

model = init_chat_model(model="claude-haiku-4-5-20251001")
embeddings = init_embeddings("openai:text-embedding-3-small")

DB_URI = "user/password@localhost:1521/FREEPDB1"

async with (
    AsyncOracleStore.from_conn_string(
        DB_URI,
        index={"embed": embeddings, "dims": 1536},
    ) as store,
    AsyncOracleSaver.from_conn_string(DB_URI) as checkpointer,
):
    await store.setup()
    await checkpointer.setup()

    async def call_model(
        state: MessagesState,
        config: RunnableConfig,
        *,
        store: BaseStore,
    ):
        user_id = config["configurable"]["user_id"]
        namespace = ("memories", user_id)
        memories = await store.asearch(namespace, query=str(state["messages"][-1].content))
        info = "\n".join([d.value["data"] for d in memories])
        system_msg = f"You are a helpful assistant talking to the user. User info: {info}"

        # Store new memories if the user asks the model to remember
        last_message = state["messages"][-1]
        if "remember" in last_message.content.lower():
            memory = "User name is Bob"
            await store.aput(namespace, str(uuid7()), {"data": memory})

        response = await model.ainvoke(
            [{"role": "system", "content": system_msg}] + state["messages"]
        )
        return {"messages": response}

    builder = StateGraph(MessagesState)
    builder.add_node(call_model)
    builder.add_edge(START, "call_model")

    graph = builder.compile(
        checkpointer=checkpointer,
        store=store,
    )

    config = {
        "configurable": {
            "thread_id": "1",
            "user_id": "1",
        }
    }
    stream = await graph.astream_events(
        {"messages": [{"role": "user", "content": "Hi! Remember: my name is Bob"}]},
        config,
        version="v3",
    )
    async for snapshot in stream.values:
        snapshot["messages"][-1].pretty_print()

    config = {
        "configurable": {
            "thread_id": "2",
            "user_id": "1",
        }
    }

    stream = await graph.astream_events(
        {"messages": [{"role": "user", "content": "what is my name?"}]},
        config,
        version="v3",
    )
    async for snapshot in stream.values:
        snapshot["messages"][-1].pretty_print()
使用语义搜索
在您的图内存存储中启用语义搜索,以使图智能体能够通过语义相似性在存储中搜索项目。 :::pythonfrom langchain.embeddings import init_embeddings
from langgraph.store.memory import InMemoryStore
# Create store with semantic search enabled
embeddings = init_embeddings("openai:text-embedding-3-small")
store = InMemoryStore(
index={
"embed": embeddings,
"dims": 1536,
}
)
store.put(("user_123", "memories"), "1", {"text": "I love pizza"})
store.put(("user_123", "memories"), "2", {"text": "I am a plumber"})
items = store.search(
("user_123", "memories"), query="I'm hungry", limit=1
)
import { OpenAIEmbeddings } from "@langchain/openai";
import { InMemoryStore } from "@langchain/langgraph";

// Create store with semantic search enabled
const embeddings = new OpenAIEmbeddings({ model: "text-embedding-3-small" });
const store = new InMemoryStore({
  index: {
    embeddings,
    dims: 1536,
  },
});

await store.put(["user_123", "memories"], "1", { text: "I love pizza" });
await store.put(["user_123", "memories"], "2", { text: "I am a plumber" });

const items = await store.search(["user_123", "memories"], {
  query: "I'm hungry",
  limit: 1,
});
InMemoryStore 适合开发环境。生产环境请使用 PostgresStore、MongoDBStore 或 RedisStore 等持久化存储。Long-term memory with semantic search
Long-term memory with semantic search
:::python::::::js:::
from langchain.embeddings import init_embeddings
from langchain.chat_models import init_chat_model
from langgraph.store.memory import InMemoryStore
from langgraph.graph import START, MessagesState, StateGraph
from langgraph.runtime import Runtime

model = init_chat_model("gpt-5.4-mini")

# Create store with semantic search enabled
embeddings = init_embeddings("openai:text-embedding-3-small")
store = InMemoryStore(
    index={
        "embed": embeddings,
        "dims": 1536,
    }
)

store.put(("user_123", "memories"), "1", {"text": "I love pizza"})
store.put(("user_123", "memories"), "2", {"text": "I am a plumber"})

async def chat(state: MessagesState, runtime: Runtime):
    # Search based on user's last message
    items = await runtime.store.asearch(
        ("user_123", "memories"), query=state["messages"][-1].content
    )
    memories = "\n".join(
        item.value["text"]
        for item in items
        if item.score is not None and item.score > 0.2
    )
    memories = f"## Memories of user\n{memories}" if memories else ""
    response = await model.ainvoke(
        [
            {"role": "system", "content": f"You are a helpful assistant.\n{memories}"},
            *state["messages"],
        ]
    )
    return {"messages": [response]}


builder = StateGraph(MessagesState)
builder.add_node(chat)
builder.add_edge(START, "chat")
graph = builder.compile(store=store)

stream = await graph.astream_events(
    {"messages": [{"role": "user", "content": "I'm hungry"}]},
    version="v3",
)
async for message in stream.messages:
    async for token in message.text:
        print(token, end="", flush=True)
- InMemoryStore
- MongoDB (manual embedding)
- MongoDB (auto embedding)
import { OpenAIEmbeddings, ChatOpenAI } from "@langchain/openai";
import { StateGraph, StateSchema, MessagesValue, GraphNode, START, InMemoryStore } from "@langchain/langgraph";

const State = new StateSchema({
  messages: MessagesValue,
});

const model = new ChatOpenAI({ model: "gpt-5.4-mini" });

// Create store with semantic search enabled
const embeddings = new OpenAIEmbeddings({ model: "text-embedding-3-small" });
const store = new InMemoryStore({
  index: {
    embeddings,
    dims: 1536,
  }
});

await store.put(["user_123", "memories"], "1", { text: "I love pizza" });
await store.put(["user_123", "memories"], "2", { text: "I am a plumber" });

const chat: GraphNode<typeof State> = async (state, runtime) => {
  // Search based on user's last message
  const items = await runtime.store.search(
    ["user_123", "memories"],
    { query: state.messages.at(-1)?.content }
  );
  const memories = items
    .filter((item) => item.score != null && item.score > 0.2)
    .map((item) => item.value.text)
    .join("\n");
  const memoriesText = memories ? `## Memories of user\n${memories}` : "";

  const response = await model.invoke([
    { role: "system", content: `You are a helpful assistant.\n${memoriesText}` },
    ...state.messages,
  ]);

  return { messages: [response] };
};

const builder = new StateGraph(State)
  .addNode("chat", chat)
  .addEdge(START, "chat");
const graph = builder.compile({ store });

const stream = await graph.streamEvents(
  { messages: [{ role: "user", content: "I'm hungry" }] },
  { version: "v3" }
);
for await (const message of stream.messages) {
  for await (const token of message.text) {
    process.stdout.write(token);
  }
}
import { ChatOpenAI, OpenAIEmbeddings } from "@langchain/openai";
import { MongoDBStore } from "@langchain/langgraph-checkpoint-mongodb";
import { StateGraph, StateSchema, MessagesValue, GraphNode, START } from "@langchain/langgraph";

const State = new StateSchema({
  messages: MessagesValue,
});

const model = new ChatOpenAI({ model: "gpt-5.4-mini" });

// Create store with semantic search enabled
const MONGODB_URI = "mongodb://user:password@localhost:27017";
const store = await MongoDBStore.fromConnString(MONGODB_URI, {
  dbName: "langgraph",
  collectionName: "store",
  embeddings: new OpenAIEmbeddings({ model: "text-embedding-3-small" }),
  indexConfig: {
    name: "store_vector_index",
    dims: 1536,
    embeddingKey: "text",
  },
});

await store.put(["user_123", "memories"], "1", { text: "I love pizza" });
await store.put(["user_123", "memories"], "2", { text: "I am a plumber" });

const chat: GraphNode<typeof State> = async (state, runtime) => {
  // Search based on user's last message
  const items = await runtime.store.search(
    ["user_123", "memories"],
    { query: state.messages.at(-1)?.content }
  );
  const memories = items
    .filter((item) => item.score != null && item.score > 0.2)
    .map((item) => item.value.text)
    .join("\n");
  const memoriesText = memories ? `## Memories of user\n${memories}` : "";

  const response = await model.invoke([
    { role: "system", content: `You are a helpful assistant.\n${memoriesText}` },
    ...state.messages,
  ]);

  return { messages: [response] };
};

const builder = new StateGraph(State)
  .addNode("chat", chat)
  .addEdge(START, "chat");
const graph = builder.compile({ store });

const stream = await graph.streamEvents(
  { messages: [{ role: "user", content: "I'm hungry" }] },
  { version: "v3" }
);
for await (const message of stream.messages) {
  for await (const token of message.text) {
    process.stdout.write(token);
  }
}
自动嵌入需要 MongoDB Atlas。MongoDB 通过 Voyage AI 在服务器端生成嵌入。有关更多信息,请参阅 自动嵌入文档。
import { StateGraph, StateSchema, MessagesValue, GraphNode, START } from "@langchain/langgraph";
import { MongoDBStore } from "@langchain/langgraph-checkpoint-mongodb";
import { ChatOpenAI } from "@langchain/openai";

const State = new StateSchema({
  messages: MessagesValue,
});

const model = new ChatOpenAI({ model: "gpt-5.4-mini" });

// Auto embedding: no embeddings instance needed.
// Configure the Voyage AI model and the field path MongoDB will read server-side.
const MONGODB_URI = "mongodb://user:password@localhost:27017";
const store = await MongoDBStore.fromConnString(MONGODB_URI, {
  dbName: "langgraph",
  collectionName: "store",
  indexConfig: {
    name: "store_vector_index",
    path: "value.content",  // MongoDB reads this field and embeds it server-side
    model: "voyage-4",      // Voyage AI model used by MongoDB Atlas
  },
});

// Values must have the content field matching the configured path (value.content)
await store.put(["user_123", "memories"], "1", { content: "I love pizza" });
await store.put(["user_123", "memories"], "2", { content: "I am a plumber" });

const chat: GraphNode<typeof State> = async (state, runtime) => {
  // MongoDB generates the query embedding server-side
  const items = await runtime.store.search(
    ["user_123", "memories"],
    { query: state.messages.at(-1)?.content }
  );
  const memories = items
    .filter((item) => item.score != null && item.score > 0.2)
    .map((item) => item.value.content)
    .join("\n");
  const memoriesText = memories ? `## Memories of user\n${memories}` : "";

  const response = await model.invoke([
    { role: "system", content: `You are a helpful assistant.\n${memoriesText}` },
    ...state.messages,
  ]);

  return { messages: [response] };
};

const builder = new StateGraph(State)
  .addNode("chat", chat)
  .addEdge(START, "chat");
const graph = builder.compile({ store });

const stream = await graph.streamEvents(
  { messages: [{ role: "user", content: "I'm hungry" }] },
  { version: "v3" }
);
for await (const message of stream.messages) {
  for await (const token of message.text) {
    process.stdout.write(token);
  }
}
管理短期记忆
启用 短期记忆 后,长对话可能会超出 LLM 的上下文窗口。常见的解决方案有:- 修剪消息:删除调用大语言模型之前的第一条或最后 N 条消息
- 删除消息:从 LangGraph 状态中永久删除消息
- 总结消息:总结历史记录中的较早消息并用摘要替换它们
- 管理检查点以存储和检索消息历史
- 自定义策略(例如,消息过滤等)
裁剪消息
:::python 大多数 LLMs 有一个最大支持的上下文窗口(以 Token 为单位)。一种决定何时截断消息的方法是计算消息历史中的 Token 数量,并在接近该限制时截断。如果你使用 LangChain,可以使用 trim messages 工具,并指定要保留的列表中的 Token 数量,以及用于处理边界的strategy(例如,保留最后一个 max_tokens)。
:::
:::js
大多数 LLMs 有一个最大支持的上下文窗口(以 Token 为单位)。一种决定何时截断消息的方法是计算消息历史中的 Token 数量,并在接近该限制时截断。如果你使用 LangChain,可以使用 trim messages 工具,并指定要保留的列表中的 Token 数量,以及用于处理边界的 strategy(例如,保留最后一个 maxTokens)。
:::
:::python
要修剪消息历史,使用 trim_messages 函数:
from langchain_core.messages.utils import (
    trim_messages,
    count_tokens_approximately
)

def call_model(state: MessagesState):
    messages = trim_messages(
        state["messages"],
        strategy="last",
        token_counter=count_tokens_approximately,
        max_tokens=128,
        start_on="human",
        end_on=("human", "tool"),
    )
    response = model.invoke(messages)
    return {"messages": [response]}

builder = StateGraph(MessagesState)
builder.add_node(call_model)
...
trimMessages 函数:
import { trimMessages } from "@langchain/core/messages";
import { StateSchema, MessagesValue, GraphNode } from "@langchain/langgraph";

const State = new StateSchema({
  messages: MessagesValue,
});

const callModel: GraphNode<typeof State> = async (state) => {
  const messages = trimMessages(state.messages, {
    strategy: "last",
    maxTokens: 128,
    startOn: "human",
    endOn: ["human", "tool"],
  });
  const response = await model.invoke(messages);
  return { messages: [response] };
};

const builder = new StateGraph(State)
  .addNode("call_model", callModel);
  // ...
Full example: trim messages
Full example: trim messages
:::python::::::js:::
from langchain_core.messages.utils import (
    trim_messages,
    count_tokens_approximately
)
from langchain.chat_models import init_chat_model
from langgraph.graph import StateGraph, START, MessagesState

model = init_chat_model("claude-sonnet-4-6")
summarization_model = model.bind(max_tokens=128)

def call_model(state: MessagesState):
    messages = trim_messages(
        state["messages"],
        strategy="last",
        token_counter=count_tokens_approximately,
        max_tokens=128,
        start_on="human",
        end_on=("human", "tool"),
    )
    response = model.invoke(messages)
    return {"messages": [response]}

checkpointer = InMemorySaver()
builder = StateGraph(MessagesState)
builder.add_node(call_model)
builder.add_edge(START, "call_model")
graph = builder.compile(checkpointer=checkpointer)

config = {"configurable": {"thread_id": "1"}}
graph.invoke({"messages": "hi, my name is bob"}, config)
graph.invoke({"messages": "write a short poem about cats"}, config)
graph.invoke({"messages": "now do the same but for dogs"}, config)
final_response = graph.invoke({"messages": "what's my name?"}, config)

final_response["messages"][-1].pretty_print()
================================== Ai Message ==================================

Your name is Bob, as you mentioned when you first introduced yourself.
import { trimMessages } from "@langchain/core/messages";
import { ChatAnthropic } from "@langchain/anthropic";
import { StateGraph, StateSchema, MessagesValue, GraphNode, START, MemorySaver } from "@langchain/langgraph";

const State = new StateSchema({
  messages: MessagesValue,
});

const model = new ChatAnthropic({ model: "claude-sonnet-4-6" });

const callModel: GraphNode<typeof State> = async (state) => {
  const messages = trimMessages(state.messages, {
    strategy: "last",
    maxTokens: 128,
    startOn: "human",
    endOn: ["human", "tool"],
    tokenCounter: model,
  });
  const response = await model.invoke(messages);
  return { messages: [response] };
};

const checkpointer = new MemorySaver();
const builder = new StateGraph(State)
  .addNode("call_model", callModel)
  .addEdge(START, "call_model");
const graph = builder.compile({ checkpointer });

const config = { configurable: { thread_id: "1" } };
await graph.invoke({ messages: [{ role: "user", content: "hi, my name is bob" }] }, config);
await graph.invoke({ messages: [{ role: "user", content: "write a short poem about cats" }] }, config);
await graph.invoke({ messages: [{ role: "user", content: "now do the same but for dogs" }] }, config);
const finalResponse = await graph.invoke({ messages: [{ role: "user", content: "what's my name?" }] }, config);

console.log(finalResponse.messages.at(-1)?.content);
Your name is Bob, as you mentioned when you first introduced yourself.
删除消息
您可以从图状态中删除消息以管理消息历史。当您想要删除特定消息或清空整个消息历史时,这很有用。 :::python 要从图状态中删除消息,可以使用RemoveMessage。为了让 RemoveMessage 正常工作,你需要使用带有 @[add_messages] 的状态键,例如 reducer,如 MessagesState。
要删除特定消息:
from langchain.messages import RemoveMessage

def delete_messages(state):
    messages = state["messages"]
    if len(messages) > 2:
        # remove the earliest two messages
        return {"messages": [RemoveMessage(id=m.id) for m in messages[:2]]}
from langgraph.graph.message import REMOVE_ALL_MESSAGES

def delete_messages(state):
    return {"messages": [RemoveMessage(id=REMOVE_ALL_MESSAGES)]}
RemoveMessage。为了让 RemoveMessage 正常工作,你需要使用一个带有 @[messagesStateReducer][messagesStateReducer] reducer,例如 MessagesValue。
要删除特定消息:
import { RemoveMessage } from "@langchain/core/messages";

const deleteMessages = (state) => {
  const messages = state.messages;
  if (messages.length > 2) {
    // remove the earliest two messages
    return {
      messages: messages
        .slice(0, 2)
        .map((m) => new RemoveMessage({ id: m.id })),
    };
  }
};
当删除消息时,务必确保生成的消息历史记录是有效的。检查您正在使用的 LLM 提供商的限制。例如:
- 一些提供者期望消息历史以
user消息开始 - 大多数提供者要求
assistant消息中包含工具调用,其后必须跟随相应的tool结果消息。
Full example: delete messages
Full example: delete messages
:::python::::::js:::
from langchain.messages import RemoveMessage

def delete_messages(state):
    messages = state["messages"]
    if len(messages) > 2:
        # remove the earliest two messages
        return {"messages": [RemoveMessage(id=m.id) for m in messages[:2]]}

def call_model(state: MessagesState):
    response = model.invoke(state["messages"])
    return {"messages": response}

builder = StateGraph(MessagesState)
builder.add_sequence([call_model, delete_messages])
builder.add_edge(START, "call_model")

checkpointer = InMemorySaver()
app = builder.compile(checkpointer=checkpointer)
config = {"configurable": {"thread_id": "1"}}

stream = app.stream_events(
    {"messages": [{"role": "user", "content": "hi! I'm bob"}]},
    config,
    version="v3"
)
for snapshot in stream.values:
    print([(message.type, message.content) for message in snapshot["messages"]])

stream = app.stream_events(
    {"messages": [{"role": "user", "content": "what's my name?"}]},
    config,
    version="v3"
)
for snapshot in stream.values:
    print([(message.type, message.content) for message in snapshot["messages"]])
[('human', "hi! I'm bob")]
[('human', "hi! I'm bob"), ('ai', 'Hi Bob! How are you doing today? Is there anything I can help you with?')]
[('human', "hi! I'm bob"), ('ai', 'Hi Bob! How are you doing today? Is there anything I can help you with?'), ('human', "what's my name?")]
[('human', "hi! I'm bob"), ('ai', 'Hi Bob! How are you doing today? Is there anything I can help you with?'), ('human', "what's my name?"), ('ai', 'Your name is Bob.')]
[('human', "what's my name?"), ('ai', 'Your name is Bob.')]
import { RemoveMessage } from "@langchain/core/messages";
import { ChatAnthropic } from "@langchain/anthropic";
import { StateGraph, StateSchema, MessagesValue, GraphNode, START, MemorySaver } from "@langchain/langgraph";

const State = new StateSchema({
  messages: MessagesValue,
});

const model = new ChatAnthropic({ model: "claude-sonnet-4-6" });

const deleteMessages: GraphNode<typeof State> = (state) => {
  const messages = state.messages;
  if (messages.length > 2) {
    // remove the earliest two messages
    return { messages: messages.slice(0, 2).map(m => new RemoveMessage({ id: m.id })) };
  }
  return {};
};

const callModel: GraphNode<typeof State> = async (state) => {
  const response = await model.invoke(state.messages);
  return { messages: [response] };
};

const builder = new StateGraph(State)
  .addNode("call_model", callModel)
  .addNode("delete_messages", deleteMessages)
  .addEdge(START, "call_model")
  .addEdge("call_model", "delete_messages");

const checkpointer = new MemorySaver();
const app = builder.compile({ checkpointer });

const config = { configurable: { thread_id: "1" } };

const stream1 = await app.streamEvents(
  { messages: [{ role: "user", content: "hi! I'm bob" }] },
  { ...config, version: "v3" }
);
for await (const snapshot of stream1.values) {
  console.log(snapshot.messages.map(message => [message.getType(), message.content]));
}

const stream2 = await app.streamEvents(
  { messages: [{ role: "user", content: "what's my name?" }] },
  { ...config, version: "v3" }
);
for await (const snapshot of stream2.values) {
  console.log(snapshot.messages.map(message => [message.getType(), message.content]));
}
[['human', "hi! I'm bob"]]
[['human', "hi! I'm bob"], ['ai', 'Hi Bob! How are you doing today? Is there anything I can help you with?']]
[['human', "hi! I'm bob"], ['ai', 'Hi Bob! How are you doing today? Is there anything I can help you with?'], ['human', "what's my name?"]]
[['human', "hi! I'm bob"], ['ai', 'Hi Bob! How are you doing today? Is there anything I can help you with?'], ['human', "what's my name?"], ['ai', 'Your name is Bob.']]
[['human', "what's my name?"], ['ai', 'Your name is Bob.']]
摘要消息
修剪或删除消息(如上所示)的问题在于,你可能会因筛选消息队列而丢失信息。由于这个原因,某些应用程序受益于使用对话模型对消息历史进行摘要的更复杂的方法。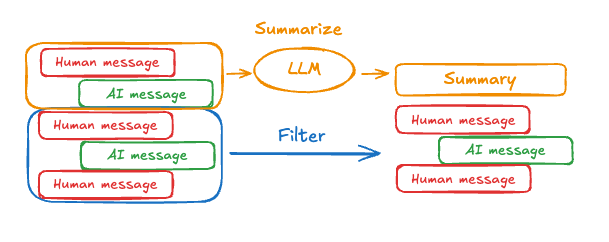
MessagesState 以包含一个 summary 键:
from langgraph.graph import MessagesState
class State(MessagesState):
    summary: str
summarize_conversation 节点可以在 messages 状态键中积累了一定数量的消息后被调用。
def summarize_conversation(state: State):

    # First, we get any existing summary
    summary = state.get("summary", "")

    # Create our summarization prompt
    if summary:

        # A summary already exists
        summary_message = (
            f"This is a summary of the conversation to date: {summary}\n\n"
            "Extend the summary by taking into account the new messages above:"
        )

    else:
        summary_message = "Create a summary of the conversation above:"

    # Add prompt to our history
    messages = state["messages"] + [HumanMessage(content=summary_message)]
    response = model.invoke(messages)

    # Delete all but the 2 most recent messages
    delete_messages = [RemoveMessage(id=m.id) for m in state["messages"][:-2]]
    return {"summary": response.content, "messages": delete_messages}
summary 键和 messages 键:
import { StateSchema, MessagesValue, GraphNode } from "@langchain/langgraph";
import { z } from "zod/v4";

const State = new StateSchema({
  messages: MessagesValue,
  summary: z.string().optional(),
});
messages 状态键中累积了一定数量的消息后调用这个 summarizeConversation 节点。
import { RemoveMessage, HumanMessage } from "@langchain/core/messages";

const summarizeConversation: GraphNode<typeof State> = async (state) => {
  // First, we get any existing summary
  const summary = state.summary || "";

  // Create our summarization prompt
  let summaryMessage: string;
  if (summary) {
    // A summary already exists
    summaryMessage =
      `This is a summary of the conversation to date: ${summary}\n\n` +
      "Extend the summary by taking into account the new messages above:";
  } else {
    summaryMessage = "Create a summary of the conversation above:";
  }

  // Add prompt to our history
  const messages = [
    ...state.messages,
    new HumanMessage({ content: summaryMessage })
  ];
  const response = await model.invoke(messages);

  // Delete all but the 2 most recent messages
  const deleteMessages = state.messages
    .slice(0, -2)
    .map(m => new RemoveMessage({ id: m.id }));

  return {
    summary: response.content,
    messages: deleteMessages
  };
};
Full example: summarize messages
Full example: summarize messages
:::python::::::js:::
from typing import Any, TypedDict

from langchain.chat_models import init_chat_model
from langchain.messages import AnyMessage
from langchain_core.messages.utils import count_tokens_approximately
from langgraph.graph import StateGraph, START, MessagesState
from langgraph.checkpoint.memory import InMemorySaver
from langmem.short_term import SummarizationNode, RunningSummary

model = init_chat_model("claude-sonnet-4-6")
summarization_model = model.bind(max_tokens=128)

class State(MessagesState):
    context: dict[str, RunningSummary]

class LLMInputState(TypedDict):
    summarized_messages: list[AnyMessage]
    context: dict[str, RunningSummary]

summarization_node = SummarizationNode(
    token_counter=count_tokens_approximately,
    model=summarization_model,
    max_tokens=256,
    max_tokens_before_summary=256,
    max_summary_tokens=128,
)

def call_model(state: LLMInputState):
    response = model.invoke(state["summarized_messages"])
    return {"messages": [response]}

checkpointer = InMemorySaver()
builder = StateGraph(State)
builder.add_node(call_model)
builder.add_node("summarize", summarization_node)
builder.add_edge(START, "summarize")
builder.add_edge("summarize", "call_model")
graph = builder.compile(checkpointer=checkpointer)

# Invoke the graph
config = {"configurable": {"thread_id": "1"}}
graph.invoke({"messages": "hi, my name is bob"}, config)
graph.invoke({"messages": "write a short poem about cats"}, config)
graph.invoke({"messages": "now do the same but for dogs"}, config)
final_response = graph.invoke({"messages": "what's my name?"}, config)

final_response["messages"][-1].pretty_print()
print("\nSummary:", final_response["context"]["running_summary"].summary)
- 我们将在
context字段中跟踪持续更新的摘要
SummarizationNode 所要求)。- 定义仅用于过滤的私有状态
call_model 节点的输入。- 这里传入一个私有输入状态,以隔离摘要节点返回的消息
================================== Ai Message ==================================

From our conversation, I can see that you introduced yourself as Bob. That's the name you shared with me when we began talking.

Summary: In this conversation, I was introduced to Bob, who then asked me to write a poem about cats. I composed a poem titled "The Mystery of Cats" that captured cats' graceful movements, independent nature, and their special relationship with humans. Bob then requested a similar poem about dogs, so I wrote "The Joy of Dogs," which highlighted dogs' loyalty, enthusiasm, and loving companionship. Both poems were written in a similar style but emphasized the distinct characteristics that make each pet special.
import { ChatAnthropic } from "@langchain/anthropic";
import {
  SystemMessage,
  HumanMessage,
  RemoveMessage,
} from "@langchain/core/messages";
import {
  StateGraph,
  StateSchema,
  MessagesValue,
  GraphNode,
  ConditionalEdgeRouter,
  START,
  END,
  MemorySaver,
} from "@langchain/langgraph";
import * as z from "zod";

import { v7 as uuid7 } from "uuid";
const memory = new MemorySaver();

// We will add a `summary` attribute (in addition to `messages` key)
const GraphState = new StateSchema({
  messages: MessagesValue,
  summary: z.string().default(""),
});

// We will use this model for both the conversation and the summarization
const model = new ChatAnthropic({ model: "claude-haiku-4-5-20251001" });

// Define the logic to call the model
const callModel: GraphNode<typeof GraphState> = async (state) => {
  // If a summary exists, we add this in as a system message
  const { summary } = state;
  let { messages } = state;
  if (summary) {
    const systemMessage = new SystemMessage({
      id: uuid7(),
      content: `Summary of conversation earlier: ${summary}`,
    });
    messages = [systemMessage, ...messages];
  }
  const response = await model.invoke(messages);
  // We return an object, because this will get added to the existing state
  return { messages: [response] };
};

// We now define the logic for determining whether to end or summarize the conversation
const shouldContinue: ConditionalEdgeRouter<{ InputSchema: typeof GraphState; Nodes: "summarize_conversation" }> = (state) => {
  const messages = state.messages;
  // If there are more than six messages, then we summarize the conversation
  if (messages.length > 6) {
    return "summarize_conversation";
  }
  // Otherwise we can just end
  return END;
};

const summarizeConversation: GraphNode<typeof GraphState> = async (state) => {
  // First, we summarize the conversation
  const { summary, messages } = state;
  let summaryMessage: string;
  if (summary) {
    // If a summary already exists, we use a different system prompt
    // to summarize it than if one didn't
    summaryMessage =
      `This is summary of the conversation to date: ${summary}\n\n` +
      "Extend the summary by taking into account the new messages above:";
  } else {
    summaryMessage = "Create a summary of the conversation above:";
  }

  const allMessages = [
    ...messages,
    new HumanMessage({ id: uuid7(), content: summaryMessage }),
  ];

  const response = await model.invoke(allMessages);

  // We now need to delete messages that we no longer want to show up
  // I will delete all but the last two messages, but you can change this
  const deleteMessages = messages
    .slice(0, -2)
    .map((m) => new RemoveMessage({ id: m.id! }));

  if (typeof response.content !== "string") {
    throw new Error("Expected a string response from the model");
  }

  return { summary: response.content, messages: deleteMessages };
};

// Define a new graph
const workflow = new StateGraph(GraphState)
  // Define the conversation node and the summarize node
  .addNode("conversation", callModel)
  .addNode("summarize_conversation", summarizeConversation)
  // Set the entrypoint as conversation
  .addEdge(START, "conversation")
  // We now add a conditional edge
  .addConditionalEdges(
    // First, we define the start node. We use `conversation`.
    // This means these are the edges taken after the `conversation` node is called.
    "conversation",
    // Next, we pass in the function that will determine which node is called next.
    shouldContinue,
  )
  // We now add a normal edge from `summarize_conversation` to END.
  // This means that after `summarize_conversation` is called, we end.
  .addEdge("summarize_conversation", END);

// Finally, we compile it!
const app = workflow.compile({ checkpointer: memory });
管理检查点
您可以通过检查点存储器查看和删除存储的信息。查看会话状态
:::python- Graph/Functional API
- Checkpointer API
config = {
    "configurable": {
        "thread_id": "1",
        # optionally provide an ID for a specific checkpoint,
        # otherwise the latest checkpoint is shown
        # "checkpoint_id": "1f029ca3-1f5b-6704-8004-820c16b69a5a"

    }
}
graph.get_state(config)
StateSnapshot(
    values={'messages': [HumanMessage(content="hi! I'm bob"), AIMessage(content='Hi Bob! How are you doing today?), HumanMessage(content="what's my name?"), AIMessage(content='Your name is Bob.')]}, next=(),
    config={'configurable': {'thread_id': '1', 'checkpoint_ns': '', 'checkpoint_id': '1f029ca3-1f5b-6704-8004-820c16b69a5a'}},
    metadata={
        'source': 'loop',
        'writes': {'call_model': {'messages': AIMessage(content='Your name is Bob.')}},
        'step': 4,
        'parents': {},
        'thread_id': '1'
    },
    created_at='2025-05-05T16:01:24.680462+00:00',
    parent_config={'configurable': {'thread_id': '1', 'checkpoint_ns': '', 'checkpoint_id': '1f029ca3-1790-6b0a-8003-baf965b6a38f'}},
    tasks=(),
    interrupts=()
)
config = {
    "configurable": {
        "thread_id": "1",
        # optionally provide an ID for a specific checkpoint,
        # otherwise the latest checkpoint is shown
        # "checkpoint_id": "1f029ca3-1f5b-6704-8004-820c16b69a5a"

    }
}
checkpointer.get_tuple(config)
CheckpointTuple(
    config={'configurable': {'thread_id': '1', 'checkpoint_ns': '', 'checkpoint_id': '1f029ca3-1f5b-6704-8004-820c16b69a5a'}},
    checkpoint={
        'v': 3,
        'ts': '2025-05-05T16:01:24.680462+00:00',
        'id': '1f029ca3-1f5b-6704-8004-820c16b69a5a',
        'channel_versions': {'__start__': '00000000000000000000000000000005.0.5290678567601859', 'messages': '00000000000000000000000000000006.0.3205149138784782', 'branch:to:call_model': '00000000000000000000000000000006.0.14611156755133758'}, 'versions_seen': {'__input__': {}, '__start__': {'__start__': '00000000000000000000000000000004.0.5736472536395331'}, 'call_model': {'branch:to:call_model': '00000000000000000000000000000005.0.1410174088651449'}},
        'channel_values': {'messages': [HumanMessage(content="hi! I'm bob"), AIMessage(content='Hi Bob! How are you doing today?), HumanMessage(content="what's my name?"), AIMessage(content='Your name is Bob.')]},
    },
    metadata={
        'source': 'loop',
        'writes': {'call_model': {'messages': AIMessage(content='Your name is Bob.')}},
        'step': 4,
        'parents': {},
        'thread_id': '1'
    },
    parent_config={'configurable': {'thread_id': '1', 'checkpoint_ns': '', 'checkpoint_id': '1f029ca3-1790-6b0a-8003-baf965b6a38f'}},
    pending_writes=[]
)
const config = {
  configurable: {
    thread_id: "1",
    // optionally provide an ID for a specific checkpoint,
    // otherwise the latest checkpoint is shown
    // checkpoint_id: "1f029ca3-1f5b-6704-8004-820c16b69a5a"
  },
};
await graph.getState(config);
{
  values: { messages: [HumanMessage(...), AIMessage(...), HumanMessage(...), AIMessage(...)] },
  next: [],
  config: { configurable: { thread_id: '1', checkpoint_ns: '', checkpoint_id: '1f029ca3-1f5b-6704-8004-820c16b69a5a' } },
  metadata: {
    source: 'loop',
    writes: { call_model: { messages: AIMessage(...) } },
    step: 4,
    parents: {},
    thread_id: '1'
  },
  createdAt: '2025-05-05T16:01:24.680462+00:00',
  parentConfig: { configurable: { thread_id: '1', checkpoint_ns: '', checkpoint_id: '1f029ca3-1790-6b0a-8003-baf965b6a38f' } },
  tasks: [],
  interrupts: []
}
查看会话历史记录
:::python- Graph/Functional API
- Checkpointer API
config = {
    "configurable": {
        "thread_id": "1"
    }
}
list(graph.get_state_history(config))
[
    StateSnapshot(
        values={'messages': [HumanMessage(content="hi! I'm bob"), AIMessage(content='Hi Bob! How are you doing today? Is there anything I can help you with?'), HumanMessage(content="what's my name?"), AIMessage(content='Your name is Bob.')]},
        next=(),
        config={'configurable': {'thread_id': '1', 'checkpoint_ns': '', 'checkpoint_id': '1f029ca3-1f5b-6704-8004-820c16b69a5a'}},
        metadata={'source': 'loop', 'writes': {'call_model': {'messages': AIMessage(content='Your name is Bob.')}}, 'step': 4, 'parents': {}, 'thread_id': '1'},
        created_at='2025-05-05T16:01:24.680462+00:00',
        parent_config={'configurable': {'thread_id': '1', 'checkpoint_ns': '', 'checkpoint_id': '1f029ca3-1790-6b0a-8003-baf965b6a38f'}},
        tasks=(),
        interrupts=()
    ),
    StateSnapshot(
        values={'messages': [HumanMessage(content="hi! I'm bob"), AIMessage(content='Hi Bob! How are you doing today? Is there anything I can help you with?'), HumanMessage(content="what's my name?")]},
        next=('call_model',),
        config={'configurable': {'thread_id': '1', 'checkpoint_ns': '', 'checkpoint_id': '1f029ca3-1790-6b0a-8003-baf965b6a38f'}},
        metadata={'source': 'loop', 'writes': None, 'step': 3, 'parents': {}, 'thread_id': '1'},
        created_at='2025-05-05T16:01:23.863421+00:00',
        parent_config={...}
        tasks=(PregelTask(id='8ab4155e-6b15-b885-9ce5-bed69a2c305c', name='call_model', path=('__pregel_pull', 'call_model'), error=None, interrupts=(), state=None, result={'messages': AIMessage(content='Your name is Bob.')}),),
        interrupts=()
    ),
    StateSnapshot(
        values={'messages': [HumanMessage(content="hi! I'm bob"), AIMessage(content='Hi Bob! How are you doing today? Is there anything I can help you with?')]},
        next=('__start__',),
        config={...},
        metadata={'source': 'input', 'writes': {'__start__': {'messages': [{'role': 'user', 'content': "what's my name?"}]}}, 'step': 2, 'parents': {}, 'thread_id': '1'},
        created_at='2025-05-05T16:01:23.863173+00:00',
        parent_config={...}
        tasks=(PregelTask(id='24ba39d6-6db1-4c9b-f4c5-682aeaf38dcd', name='__start__', path=('__pregel_pull', '__start__'), error=None, interrupts=(), state=None, result={'messages': [{'role': 'user', 'content': "what's my name?"}]}),),
        interrupts=()
    ),
    StateSnapshot(
        values={'messages': [HumanMessage(content="hi! I'm bob"), AIMessage(content='Hi Bob! How are you doing today? Is there anything I can help you with?')]},
        next=(),
        config={...},
        metadata={'source': 'loop', 'writes': {'call_model': {'messages': AIMessage(content='Hi Bob! How are you doing today? Is there anything I can help you with?')}}, 'step': 1, 'parents': {}, 'thread_id': '1'},
        created_at='2025-05-05T16:01:23.862295+00:00',
        parent_config={...}
        tasks=(),
        interrupts=()
    ),
    StateSnapshot(
        values={'messages': [HumanMessage(content="hi! I'm bob")]},
        next=('call_model',),
        config={...},
        metadata={'source': 'loop', 'writes': None, 'step': 0, 'parents': {}, 'thread_id': '1'},
        created_at='2025-05-05T16:01:22.278960+00:00',
        parent_config={...}
        tasks=(PregelTask(id='8cbd75e0-3720-b056-04f7-71ac805140a0', name='call_model', path=('__pregel_pull', 'call_model'), error=None, interrupts=(), state=None, result={'messages': AIMessage(content='Hi Bob! How are you doing today? Is there anything I can help you with?')}),),
        interrupts=()
    ),
    StateSnapshot(
        values={'messages': []},
        next=('__start__',),
        config={'configurable': {'thread_id': '1', 'checkpoint_ns': '', 'checkpoint_id': '1f029ca3-0870-6ce2-bfff-1f3f14c3e565'}},
        metadata={'source': 'input', 'writes': {'__start__': {'messages': [{'role': 'user', 'content': "hi! I'm bob"}]}}, 'step': -1, 'parents': {}, 'thread_id': '1'},
        created_at='2025-05-05T16:01:22.277497+00:00',
        parent_config=None,
        tasks=(PregelTask(id='d458367b-8265-812c-18e2-33001d199ce6', name='__start__', path=('__pregel_pull', '__start__'), error=None, interrupts=(), state=None, result={'messages': [{'role': 'user', 'content': "hi! I'm bob"}]}),),
        interrupts=()
    )
]
config = {
    "configurable": {
        "thread_id": "1"
    }
}
list(checkpointer.list(config))
[
    CheckpointTuple(
        config={'configurable': {'thread_id': '1', 'checkpoint_ns': '', 'checkpoint_id': '1f029ca3-1f5b-6704-8004-820c16b69a5a'}},
        checkpoint={
            'v': 3,
            'ts': '2025-05-05T16:01:24.680462+00:00',
            'id': '1f029ca3-1f5b-6704-8004-820c16b69a5a',
            'channel_versions': {'__start__': '00000000000000000000000000000005.0.5290678567601859', 'messages': '00000000000000000000000000000006.0.3205149138784782', 'branch:to:call_model': '00000000000000000000000000000006.0.14611156755133758'},
            'versions_seen': {'__input__': {}, '__start__': {'__start__': '00000000000000000000000000000004.0.5736472536395331'}, 'call_model': {'branch:to:call_model': '00000000000000000000000000000005.0.1410174088651449'}},
            'channel_values': {'messages': [HumanMessage(content="hi! I'm bob"), AIMessage(content='Hi Bob! How are you doing today? Is there anything I can help you with?'), HumanMessage(content="what's my name?"), AIMessage(content='Your name is Bob.')]},
        },
        metadata={'source': 'loop', 'writes': {'call_model': {'messages': AIMessage(content='Your name is Bob.')}}, 'step': 4, 'parents': {}, 'thread_id': '1'},
        parent_config={'configurable': {'thread_id': '1', 'checkpoint_ns': '', 'checkpoint_id': '1f029ca3-1790-6b0a-8003-baf965b6a38f'}},
        pending_writes=[]
    ),
    CheckpointTuple(
        config={'configurable': {'thread_id': '1', 'checkpoint_ns': '', 'checkpoint_id': '1f029ca3-1790-6b0a-8003-baf965b6a38f'}},
        checkpoint={
            'v': 3,
            'ts': '2025-05-05T16:01:23.863421+00:00',
            'id': '1f029ca3-1790-6b0a-8003-baf965b6a38f',
            'channel_versions': {'__start__': '00000000000000000000000000000005.0.5290678567601859', 'messages': '00000000000000000000000000000006.0.3205149138784782', 'branch:to:call_model': '00000000000000000000000000000006.0.14611156755133758'},
            'versions_seen': {'__input__': {}, '__start__': {'__start__': '00000000000000000000000000000004.0.5736472536395331'}, 'call_model': {'branch:to:call_model': '00000000000000000000000000000005.0.1410174088651449'}},
            'channel_values': {'messages': [HumanMessage(content="hi! I'm bob"), AIMessage(content='Hi Bob! How are you doing today? Is there anything I can help you with?'), HumanMessage(content="what's my name?")], 'branch:to:call_model': None}
        },
        metadata={'source': 'loop', 'writes': None, 'step': 3, 'parents': {}, 'thread_id': '1'},
        parent_config={...},
        pending_writes=[('8ab4155e-6b15-b885-9ce5-bed69a2c305c', 'messages', AIMessage(content='Your name is Bob.'))]
    ),
    CheckpointTuple(
        config={...},
        checkpoint={
            'v': 3,
            'ts': '2025-05-05T16:01:23.863173+00:00',
            'id': '1f029ca3-1790-616e-8002-9e021694a0cd',
            'channel_versions': {'__start__': '00000000000000000000000000000004.0.5736472536395331', 'messages': '00000000000000000000000000000003.0.7056767754077798', 'branch:to:call_model': '00000000000000000000000000000003.0.22059023329132854'},
            'versions_seen': {'__input__': {}, '__start__': {'__start__': '00000000000000000000000000000001.0.7040775356287469'}, 'call_model': {'branch:to:call_model': '00000000000000000000000000000002.0.9300422176788571'}},
            'channel_values': {'__start__': {'messages': [{'role': 'user', 'content': "what's my name?"}]}, 'messages': [HumanMessage(content="hi! I'm bob"), AIMessage(content='Hi Bob! How are you doing today? Is there anything I can help you with?')]}
        },
        metadata={'source': 'input', 'writes': {'__start__': {'messages': [{'role': 'user', 'content': "what's my name?"}]}}, 'step': 2, 'parents': {}, 'thread_id': '1'},
        parent_config={...},
        pending_writes=[('24ba39d6-6db1-4c9b-f4c5-682aeaf38dcd', 'messages', [{'role': 'user', 'content': "what's my name?"}]), ('24ba39d6-6db1-4c9b-f4c5-682aeaf38dcd', 'branch:to:call_model', None)]
    ),
    CheckpointTuple(
        config={...},
        checkpoint={
            'v': 3,
            'ts': '2025-05-05T16:01:23.862295+00:00',
            'id': '1f029ca3-178d-6f54-8001-d7b180db0c89',
            'channel_versions': {'__start__': '00000000000000000000000000000002.0.18673090920108737', 'messages': '00000000000000000000000000000003.0.7056767754077798', 'branch:to:call_model': '00000000000000000000000000000003.0.22059023329132854'},
            'versions_seen': {'__input__': {}, '__start__': {'__start__': '00000000000000000000000000000001.0.7040775356287469'}, 'call_model': {'branch:to:call_model': '00000000000000000000000000000002.0.9300422176788571'}},
            'channel_values': {'messages': [HumanMessage(content="hi! I'm bob"), AIMessage(content='Hi Bob! How are you doing today? Is there anything I can help you with?')]}
        },
        metadata={'source': 'loop', 'writes': {'call_model': {'messages': AIMessage(content='Hi Bob! How are you doing today? Is there anything I can help you with?')}}, 'step': 1, 'parents': {}, 'thread_id': '1'},
        parent_config={...},
        pending_writes=[]
    ),
    CheckpointTuple(
        config={...},
        checkpoint={
            'v': 3,
            'ts': '2025-05-05T16:01:22.278960+00:00',
            'id': '1f029ca3-0874-6612-8000-339f2abc83b1',
            'channel_versions': {'__start__': '00000000000000000000000000000002.0.18673090920108737', 'messages': '00000000000000000000000000000002.0.30296526818059655', 'branch:to:call_model': '00000000000000000000000000000002.0.9300422176788571'},
            'versions_seen': {'__input__': {}, '__start__': {'__start__': '00000000000000000000000000000001.0.7040775356287469'}},
            'channel_values': {'messages': [HumanMessage(content="hi! I'm bob")], 'branch:to:call_model': None}
        },
        metadata={'source': 'loop', 'writes': None, 'step': 0, 'parents': {}, 'thread_id': '1'},
        parent_config={...},
        pending_writes=[('8cbd75e0-3720-b056-04f7-71ac805140a0', 'messages', AIMessage(content='Hi Bob! How are you doing today? Is there anything I can help you with?'))]
    ),
    CheckpointTuple(
        config={'configurable': {'thread_id': '1', 'checkpoint_ns': '', 'checkpoint_id': '1f029ca3-0870-6ce2-bfff-1f3f14c3e565'}},
        checkpoint={
            'v': 3,
            'ts': '2025-05-05T16:01:22.277497+00:00',
            'id': '1f029ca3-0870-6ce2-bfff-1f3f14c3e565',
            'channel_versions': {'__start__': '00000000000000000000000000000001.0.7040775356287469'},
            'versions_seen': {'__input__': {}},
            'channel_values': {'__start__': {'messages': [{'role': 'user', 'content': "hi! I'm bob"}]}}
        },
        metadata={'source': 'input', 'writes': {'__start__': {'messages': [{'role': 'user', 'content': "hi! I'm bob"}]}}, 'step': -1, 'parents': {}, 'thread_id': '1'},
        parent_config=None,
        pending_writes=[('d458367b-8265-812c-18e2-33001d199ce6', 'messages', [{'role': 'user', 'content': "hi! I'm bob"}]), ('d458367b-8265-812c-18e2-33001d199ce6', 'branch:to:call_model', None)]
    )
]
const config = {
  configurable: {
    thread_id: "1",
  },
};

const history = [];
for await (const state of graph.getStateHistory(config)) {
  history.push(state);
}
删除线程的所有检查点
:::pythonthread_id = "1"
checkpointer.delete_thread(thread_id)
const threadId = "1";
await checkpointer.deleteThread(threadId);
数据库管理
如果您使用任何数据库支持的持久化实现(如 Postgres、Redis 或 Oracle)来存储短期和/或长期记忆,则在使用前需要运行迁移来设置所需的数据库架构。 按照惯例,大多数数据库特定库会在检查点器或存储实例上定义一个setup() 方法,用于运行所需的迁移。但您仍需查阅具体的 @[BaseCheckpointSaver] 或 @[BaseStore] 实现文档,以确认确切的方法名称和用法。
我们建议将迁移操作作为独立的部署步骤,或确保在服务器启动时自动运行迁移。
官方原文:src/oss/langgraph/add-memory.mdx · 非官方翻译,译文由 AI 生成,以英文原文为准。