概述
智能体利用记忆和执行环境中的信息来完成任务。 在生产环境中,有几个基本要素决定了信息的共享和访问方式:- 线程:单个对话。消息历史记录和草稿文件默认按线程界定范围,不会跨线程传递。
- 用户:与您的智能体交互的人。记忆和文件可以是某个用户的私有数据,也可以跨用户共享。身份验证和授权来自您的 auth layer。
- 助手:配置好的智能体实例。记忆和文件可以与单个助手关联,也可以跨所有助手共享。
- LangSmith Deployments:Managed Deep Agents(推荐),或带有认证、Webhooks 和 cron 的自定义 LangSmith Deployment
- Production considerations:调用、多租户、认证、凭证、异步和持久性
- Memory:跨对话持久化信息
- Execution environment:文件存储和代码执行
- Guardrails:权限和数据隐私
- Frontend:将您的 UI 连接到已部署的智能体
LangSmith Deployments
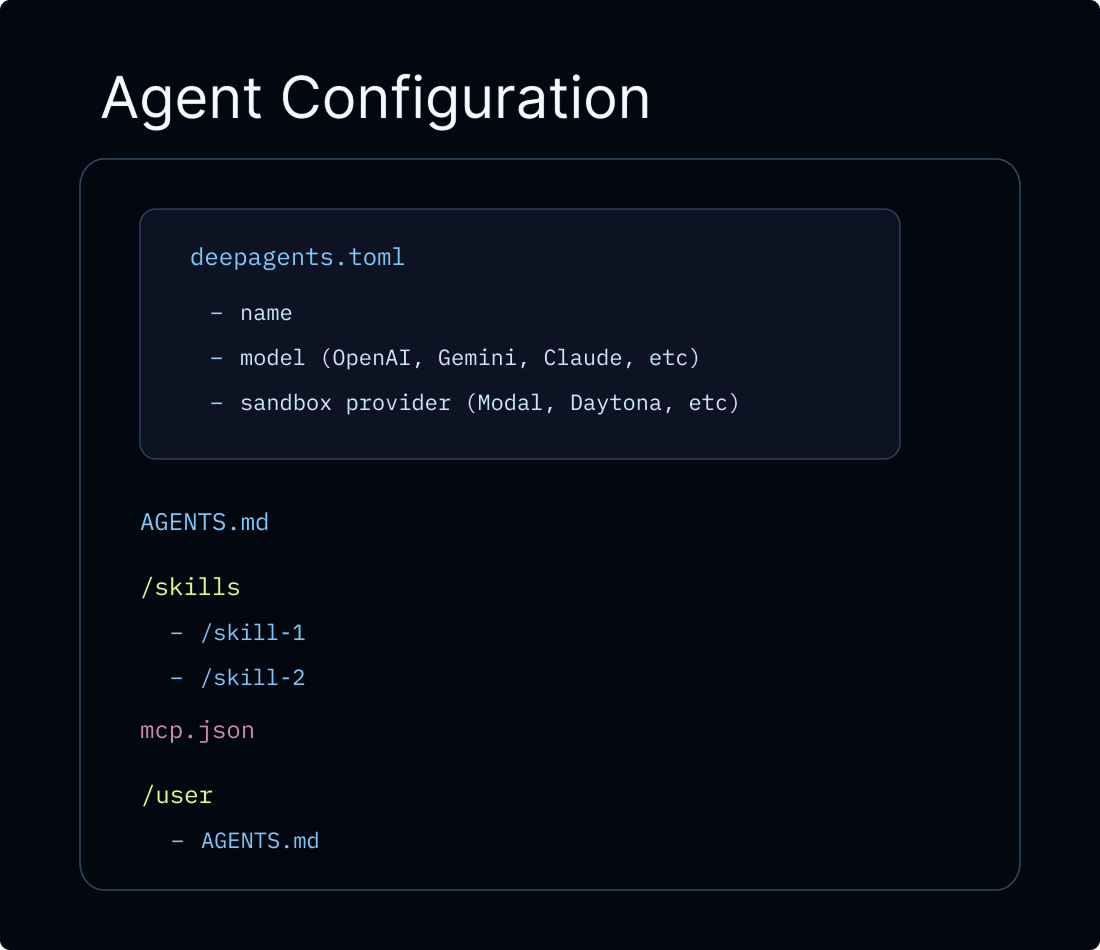


langgraph.json:
:::python
langgraph.json
langgraph.json
langgraph.json 是配置文件,它告诉 LangGraph 平台如何构建和运行您的应用程序。它位于项目的根目录下,对于本地开发(使用 langgraph dev)和生产部署都是必需的。关键字段如下:
有关完整的配置选项(自定义 Docker 步骤、存储索引、身份验证处理程序等),请参阅 应用程序结构。
生产注意事项
调用智能体
在生产环境中,每个调用都应该包含两个运行级参数:thread_id(通过config={"configurable": {"thread_id": ...}}传递):对话的稳定标识符。检查点 使用它来持久化和恢复消息历史记录,因此后续回合可以继续同一对话。生成一个新的thread_id以开始全新的对话。context:每次运行时您的工具和中间件读取的运行级数据,例如user_id、API 密钥、功能标志或会话元数据。使用context_schema定义其形状,并通过runtime.context访问它。请参阅 运行时上下文。
View example trace
为此示例打开一个公开的 LangSmith 运行。
thread_id 传递给每个运行:
View example trace
为此示例打开一个公开的 LangSmith 运行。
thread_id 传递给每个运行:
多租户
当您的智能体为多个用户服务时,您需要处理三个问题:验证每个用户是谁、控制他们可以访问什么,以及管理智能体代表他们采取行动的凭证。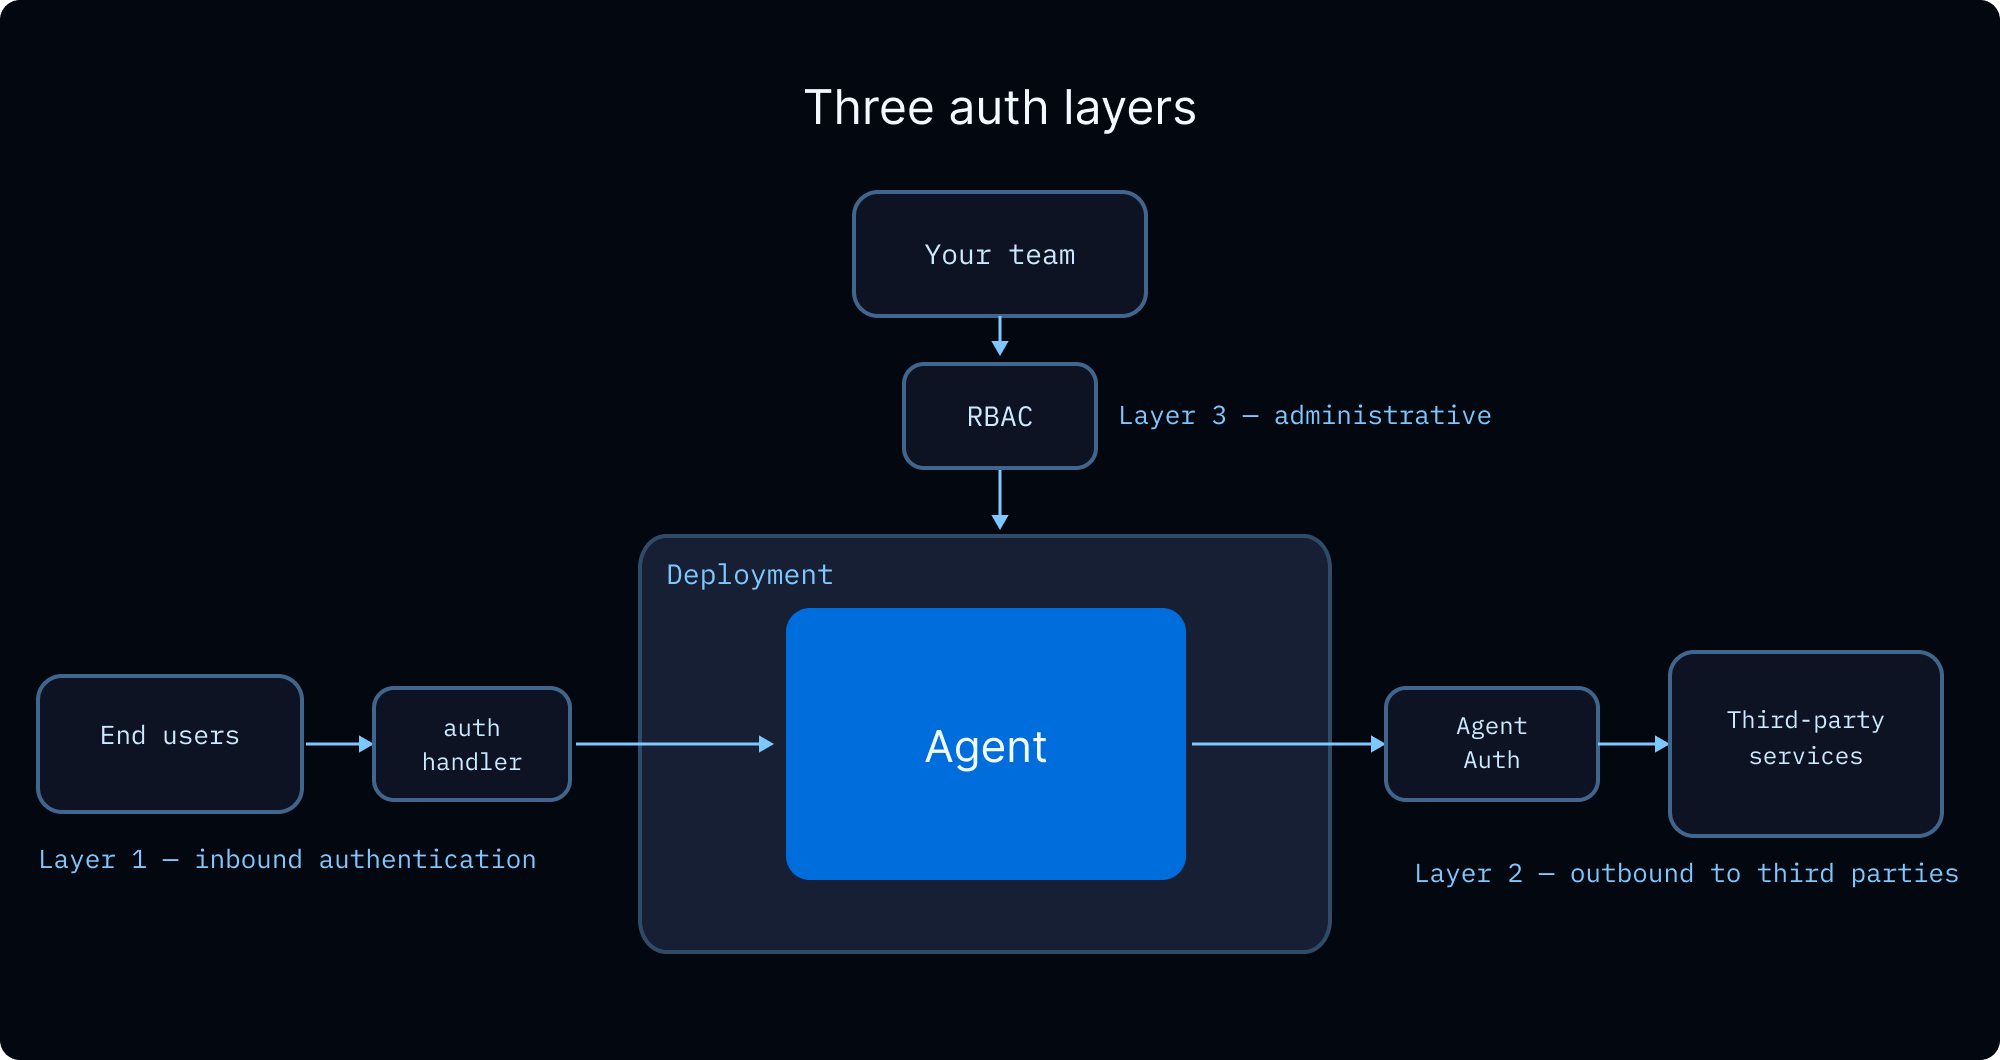
用户身份和访问控制
LangSmith 部署支持自定义认证来建立用户身份和授权处理器来控制对线程、智能体和存储命名空间的资源访问。授权处理器在认证成功后运行,可以:- 使用所有权元数据标记资源(例如,
owner: user_id) - 返回过滤器,以便用户只能看到自己的资源
- 对于未授权操作,使用 HTTP 403 拒绝访问
基于角色的访问控制
LangSmith 的基于角色的访问控制 (RBAC)管理你工作空间中哪些成员可以部署、配置和监控智能体。这与上述最终用户授权是分开的。
在 Enterprise 计划上,提供具有细粒度权限的自定义角色。有关完整权限模型的详细信息,请参阅RBAC 参考。
最终用户凭证
当你的智能体需要代表用户调用外部 API(例如,读取他们的 GitHub 仓库、发送 Slack 消息、查询他们的数据仓库)时,你需要一种方法来通过代理传递用户的凭证,而无需硬编码它们。 通过智能体认证进行 OAuth。 智能体认证提供管理的 OAuth 2.0 流程。配置 OAuth 提供商,智能体可以请求针对每个用户的令牌。在首次使用时,智能体中断执行并显示 OAuth 同意 URL。用户认证后,智能体使用有效令牌继续。令牌会自动存储和刷新。 :::python异步
基于 LLM 的应用程序高度依赖 I/O:调用语言模型、数据库和外部服务。异步编程允许这些操作并发运行而不是阻塞,从而提高吞吐量和响应能力。LangChain 遵循为异步方法名称添加
a前缀的约定(例如,ainvoke、abefore_agent、astream)。同步和异步变体位于同一类或命名空间中。- 创建异步工具。 LangChain 在单独的线程中运行同步工具以避免阻塞,但原生异步完全避免了线程开销。
- 使用异步中间件方法。 自定义 middleware 应实现异步钩子(例如,
abefore_agent而不是before_agent)。 - 使用异步处理外部资源生命周期。 创建 sandboxes 或连接到 MCP servers 涉及网络调用,应等待。这就是为什么 graph factories 预配这些资源是异步的。
可靠性
Deep Agents 在 LangGraph 上运行,LangGraph 提供了开箱即用的持久化执行。persistence 层在每一步检查点状态,因此由失败、超时或 human-in-the-loop 暂停中断的运行可以从最后记录的状态恢复,而无需重新处理之前的步骤。对于长时间运行的 deep agents(会生成许多子 agents),这意味着运行中途的失败不会丢失已完成的工作。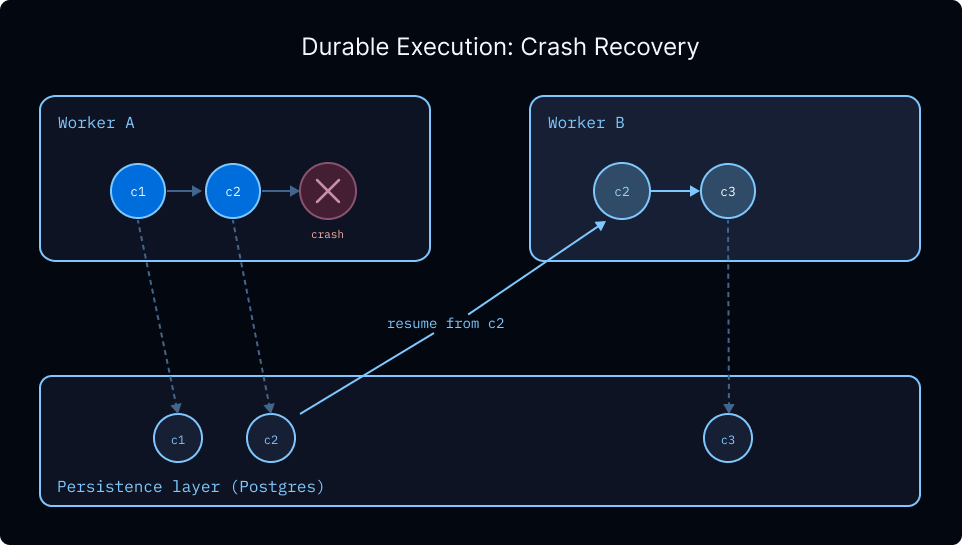
- 无限 interrupts。 Human-in-the-loop 工作流可以暂停几分钟或几天,并从停止的地方精确恢复。
- Time travel。 每个检查点步骤都是一个快照,你可以倒带,如果出问题,可以从更早的状态重新播放。
- 安全处理敏感操作。 对于涉及支付或其他不可逆操作的流程,检查点提供审计跟踪和恢复点,以检查导致操作的精确状态。
记忆
没有记忆,每次对话都从零开始。记忆使你的智能体能够在对话中保留信息(用户偏好、学习到的指令、过去的经验),以便随着时间的推移个性化其行为。有关记忆类型的概述,请参阅 memory concepts guide。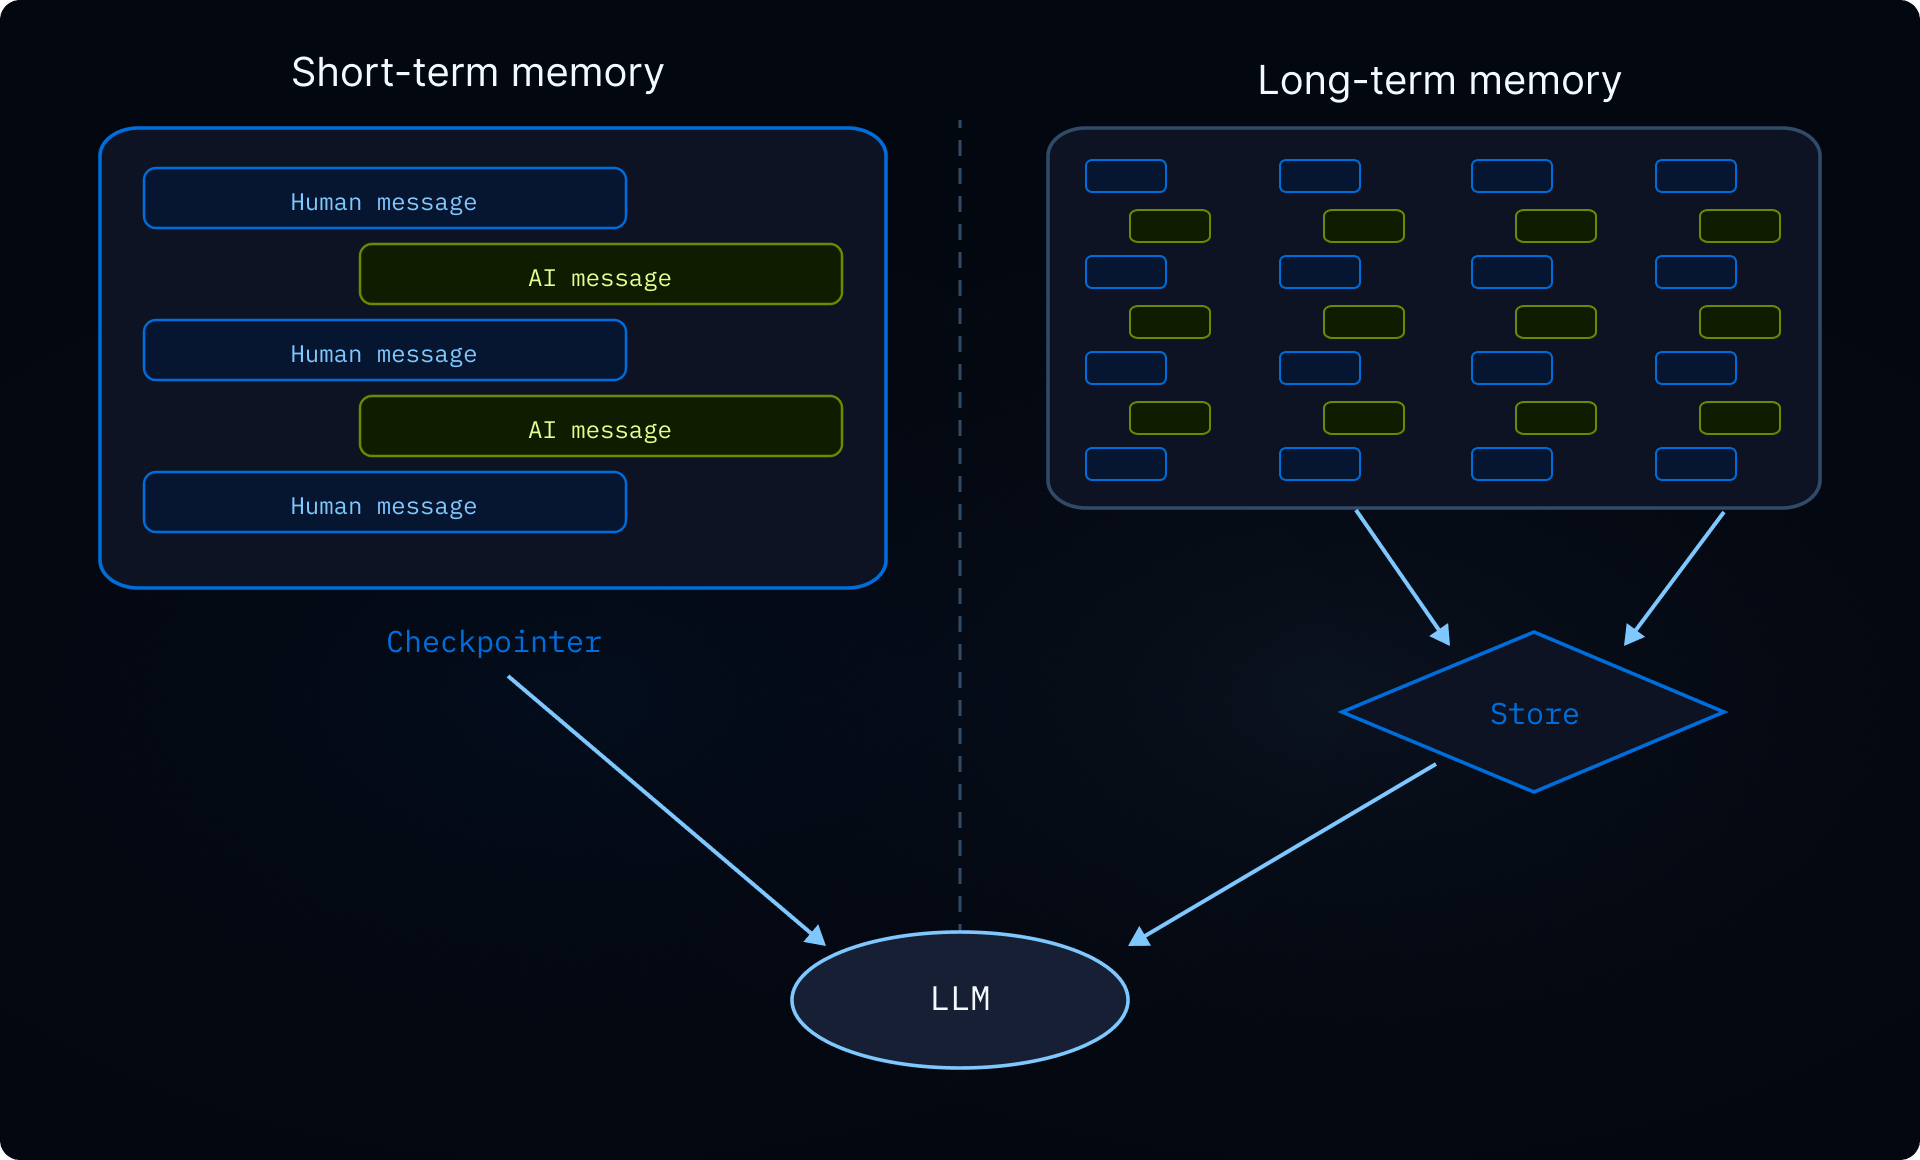
范围
记忆始终在对话之间持久化。主要问题是它如何跨用户和助手边界进行范围划分。正确的范围取决于谁应该查看和修改数据:配置
在 Deep Agents 中,内存以文件形式存储在虚拟文件系统中。默认情况下,文件限定于单个线程(对话),并且不会跨线程共享。 否则,要跨线程共享内存,将路径如/memories/ 路由到写入 LangGraph 存储 的 @[StoreBackend]。使用 @[CompositeBackend] 为智能体提供线程限定的临时空间和跨线程 长期记忆。
:::python
下面显示的
rt.server_info 和 rt.execution_info 命名空间模式需要 deepagents>=0.5.0。下面显示的
rt.serverInfo 和 rt.executionInfo 命名空间模式需要 deepagents>=1.9.0。- User (recommended)
- Assistant
- User
- Organization
按 ::::::js:::
user_id 命名空间。每个用户拥有自己的私有内存。这是推荐默认设置,因为大多数应用程序部署单个助理。:::pythonagent.py
src/agent.ts
执行环境
本地上,智能体可以直接在磁盘上读写文件并运行 shell 命令。在生产环境中,您需要考虑隔离和持久性。正确的设置取决于您的智能体是否需要执行代码:- 文件系统后端 如果你的智能体仅读取和写入文件,则足够。根据你的持久化需求选择后端:线程范围的临时空间、跨线程存储,或两者的组合。
- 沙盒 添加一个隔离的容器,包含
execute工具用于运行 shell 命令。如果智能体需要运行代码、安装包或执行文件 I/O 之外的操作,使用沙盒。
文件系统
根据需要持久化的内容选择后端:- @[StateBackend](默认):线程范围的临时空间。文件在同一个线程内的回合间通过你的检查点持久化,但不会跨线程共享。每一步都会检查点,因此避免写入大文件。
- @[StoreBackend]:跨线程存储,能在对话间持续存在。使用 命名空间工厂 进行作用域限定。
- @[CompositeBackend]:组合两者。默认为线程范围的临时空间,特定路径(如
/memories/)通过跨线程路由。
ContextHubBackend: 在 LangSmith Hub 仓库中的持久文件(owner/name或name)。当你希望使用 LangSmith 原生持久化而不需要单独配置 LangGraph 存储时使用此选项。 :::
沙盒
如果智能体需要运行代码(而不仅仅是读取和写入文件),使用 沙盒。沙盒提供文件系统和用于运行 shell 命令的execute 工具,所有内容都在隔离的容器内。这种隔离也保护了你的主机:如果智能体的代码耗尽内存或崩溃,仅沙盒受影响。你的服务器保持运行。
生命周期
关键决策是沙盒的存活时间。每个对话是否获得一个全新的沙盒,还是对话共享持久化的环境?下方的示例使用异步 图工厂 而不是静态图,因为沙盒需要
thread_id 或 assistant_id 来查找或创建正确的沙盒。图工厂不会接收完整的 Runtime(没有 server_info 或 execution_info);相反,接受一个 RunnableConfig 并从 config["configurable"] 读取 thread_id 和 assistant_id。工厂是异步的,因为沙盒创建是 I/O 密集型操作,需要仅在调用时才可用的运行时信息。- Thread-scoped (most common)
- Assistant-scoped
agent 变量是一个异步函数(而不是编译的图),服务器将其视为 图工厂 并在每个运行时调用它,注入配置。工厂通过名称查找或创建沙盒,并返回一个连接到该沙盒的新智能体图。
一旦使用 langgraph deploy 部署,就在应用程序代码中使用 SDK 调用智能体。无论范围如何,客户端代码都相同。范围完全由上方的智能体工厂处理,但行为不同:
- Thread-scoped
- Assistant-scoped
每个线程都有自己的沙盒。同一线程内的后续消息会重用相同的沙盒,但新线程总是以全新的状态开始,没有来自先前对话的遗留文件或安装的包。:::python::::::js:::
client.py
client.ts
文件传输
沙盒是隔离的容器,因此您的应用程序代码不能直接访问沙盒内的文件。使用upload_files() 和 download_files() 跨越沙盒边界移动数据:
有关特定提供者的文件传输示例,请参阅 使用文件。有关提供者设置、安全性和生命周期模式,请参阅完整的 沙盒指南。
Example: syncing skills and memories with custom middleware
Example: syncing skills and memories with custom middleware
管理密钥
沙盒是隔离的容器,因此主机环境变量在沙盒内不可用。向沙盒代码提供 API 密钥和其他密钥有两种方法: 认证代理(推荐)。 沙盒认证代理拦截沙盒的出站请求并自动注入认证头。沙盒代码正常调用外部API,而代理根据目标主机添加正确的凭证。这意味着API密钥永远不会出现在沙盒代码、环境变量或日志中。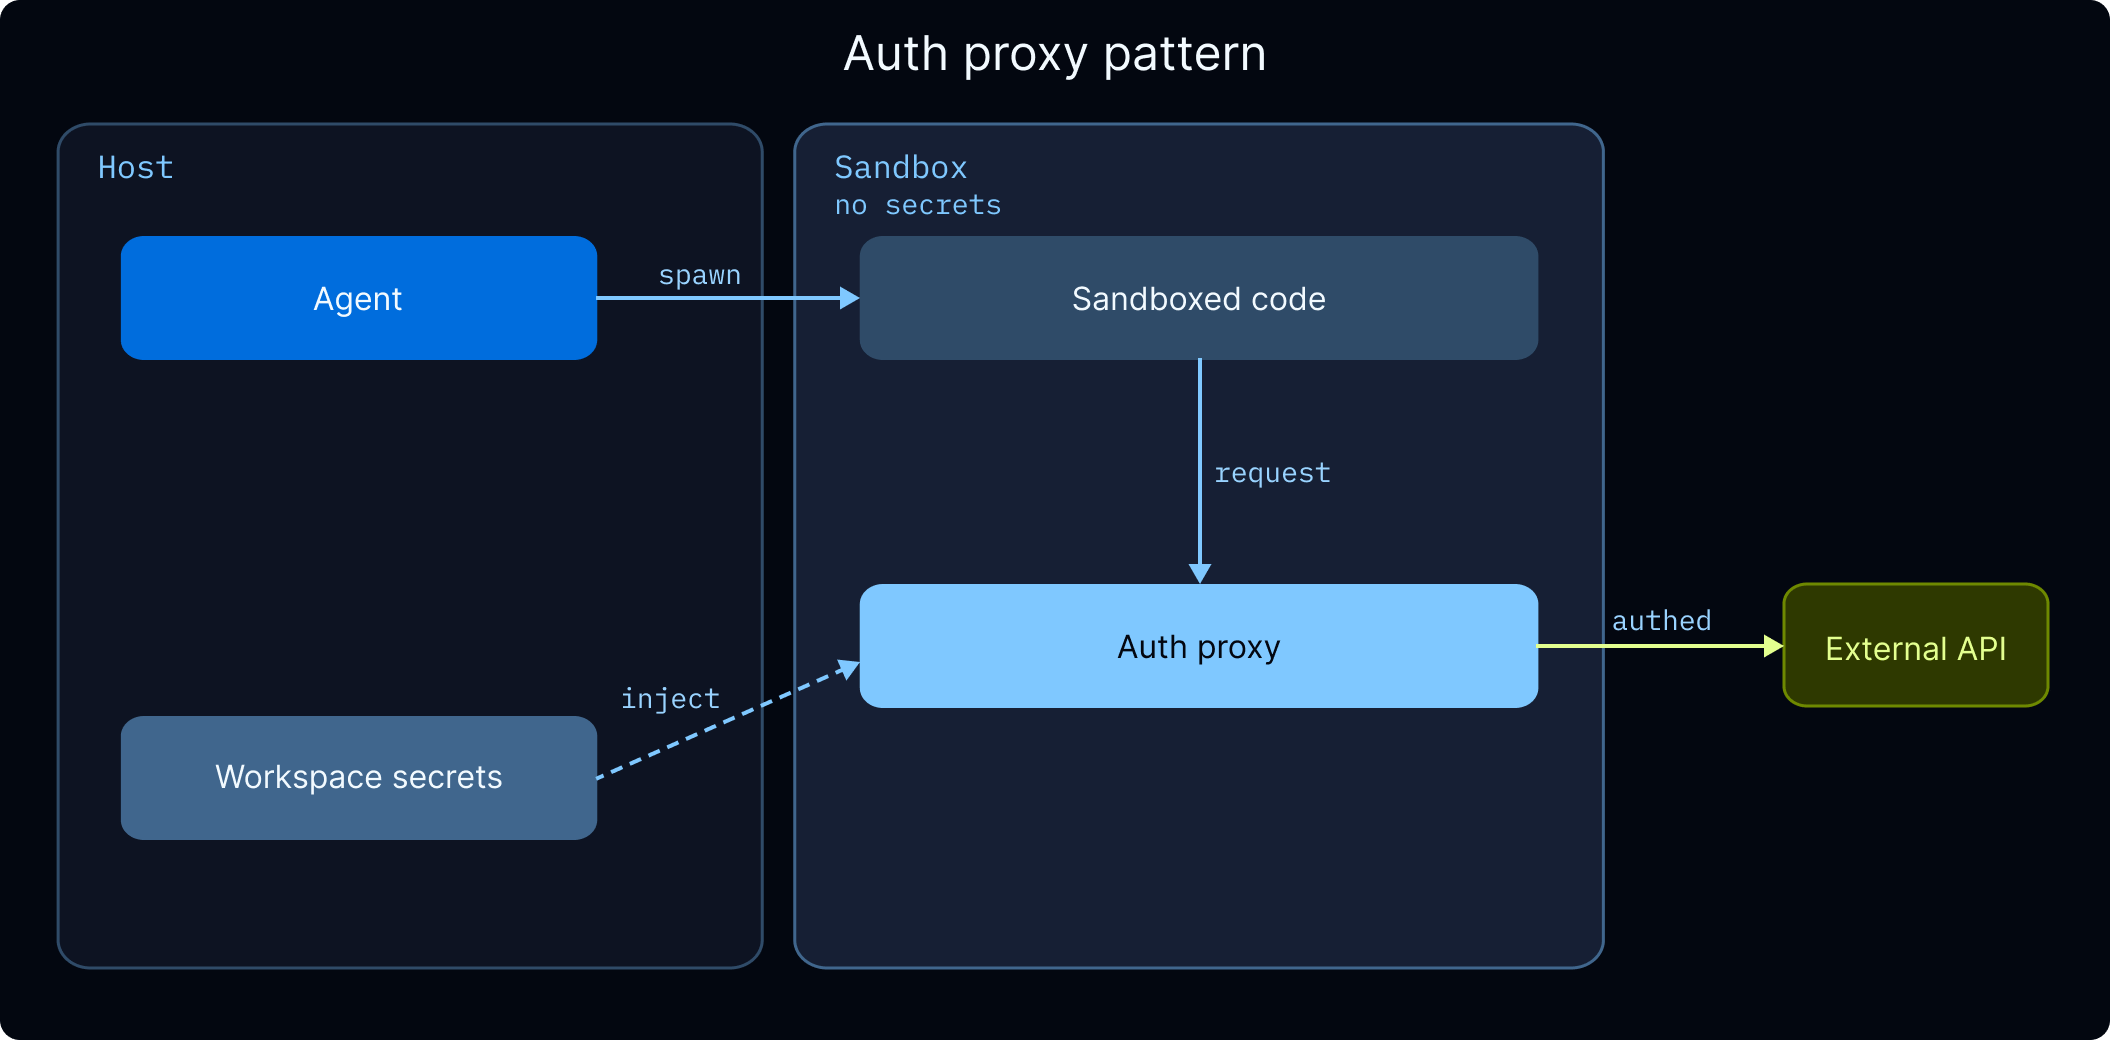
${SECRET_KEY}的引用针对LangSmith 工作区设置中存储的秘密。在创建引用它们的模板之前,请在那里配置秘密。
工作区秘密。 对于不需要基于代理注入的API密钥(例如,由智能体服务器本身使用,而不是沙盒代码),将它们存储为LangSmith的工作区秘密。这些在运行时作为工作区中所有智能体的环境变量可用。
安全约束
生产环境中的智能体独立运行,这意味着它们可能会无限循环、触发速率限制或处理包含敏感信息的用户数据。深度智能体提供两层保护:权限
权限是声明式的允许/拒绝规则,控制智能体可以读取或写入哪些文件和目录。使用权限将智能体隔离到工作目录、保护敏感文件或强制执行只读内存。规则按声明顺序评估,第一个匹配的规则生效。容错
有关速率限制、重试、回退和错误处理,请参阅Fault tolerance。数据隐私
如果您的智能体处理可能包含电子邮件、信用卡号码或其他PII的用户输入,您可以在它到达模型之前或在日志中存储之前检测和处理它: :::pythonredact(替换为[REDACTED_EMAIL])、mask(部分掩码,如****-****-****-1234)、hash(确定性哈希)和block(引发错误)。您还可以为特定领域的模式编写自定义检测器。
:::python
参见 @[PIIMiddleware] 了解完整配置。
:::
:::js
参见 @[piiMiddleware] 了解完整配置。
:::
有关默认深度智能体中间件堆栈,请参阅Customization。有关额外的LangChain预构建中间件(重试、回退、PII检测等),请参阅Prebuilt middleware。
前端
深度智能体使用useStream 连接您的 UI 与智能体后端。@[useStream] 是一个前端钩子(适用于 React、Vue、Svelte 和 Angular),它实时流式传输智能体的消息、子智能体进度和自定义状态。
在本地,useStream 指向 http://localhost:2024。在生产环境中,将其指向您的 LangSmith 部署 并配置重连,以便在用户连接中断时不会丢失进度。
recursionLimit 以避免切断长时间运行的执行:
官方原文:src/oss/deepagents/going-to-production.mdx · 非官方翻译,译文由 AI 生成,以英文原文为准。