为什么使用多智能体?
当开发者说他们需要“多智能体”时,他们通常是在寻找以下一种或多种能力:- 上下文管理:在不使模型上下文窗口过载的情况下提供专业知识。如果上下文无限且延迟为零,你可以将所有知识都放入单个提示词中——但由于并非如此,你需要模式来选择性地展示相关信息。
- 分布式开发:允许不同团队独立开发和维护功能,并将它们组合成一个具有明确边界的大系统。
- 并行化:为子任务创建专门的工人并发执行,以获得更快的速度。
模式
以下是构建多智能体系统的主要模式,每个模式适用于不同的用例:选择模式
使用此表格将你的需求与正确的模式匹配:- 分布式开发:不同团队能否独立维护组件?
- 并行化:多个智能体能否并发执行?
- 多跳:该模式是否支持按顺序调用多个子智能体?
- 直接用户交互:子智能体能否直接与用户对话?
可视化概述
- Subagents
- Handoffs
- Skills
- Router
主智能体将子智能体作为工具进行协调。所有路由都通过主智能体。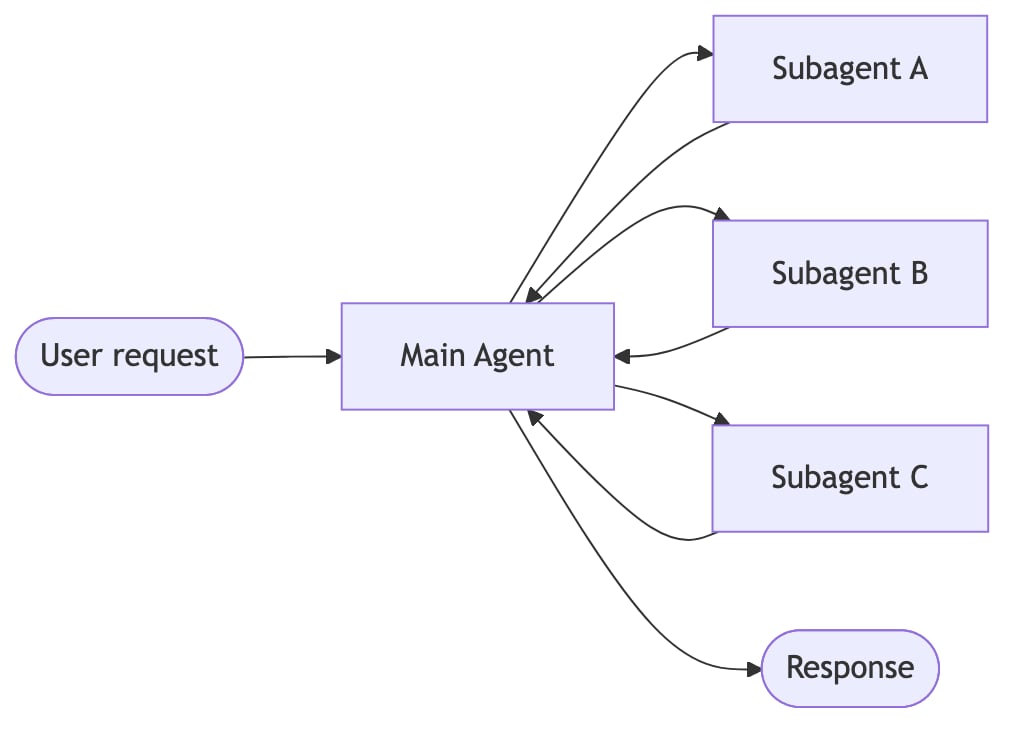
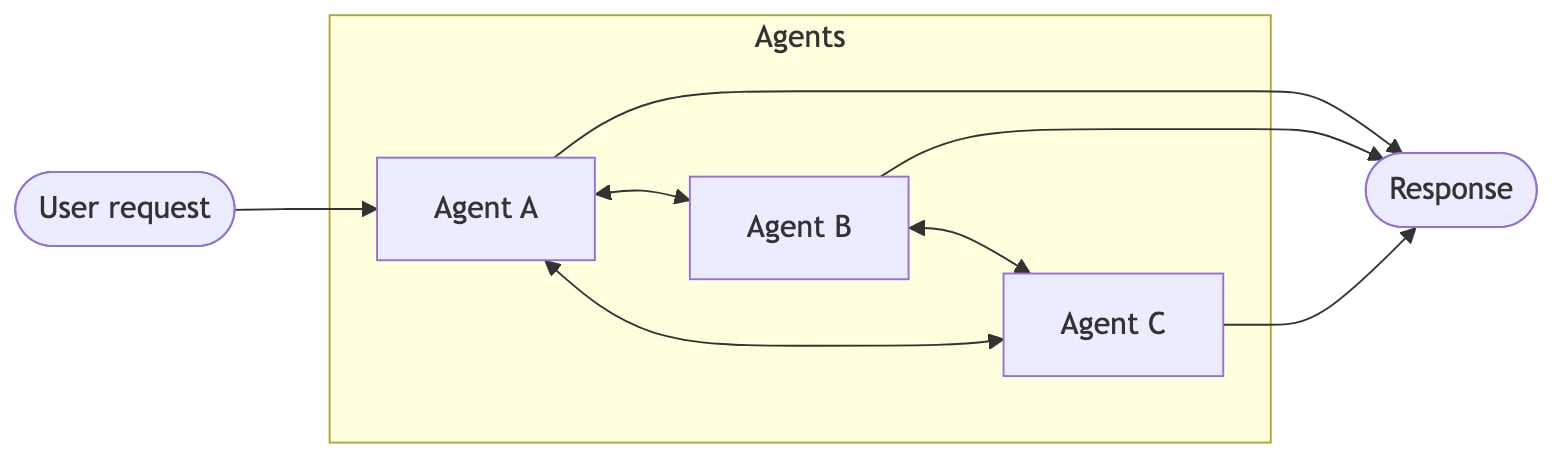
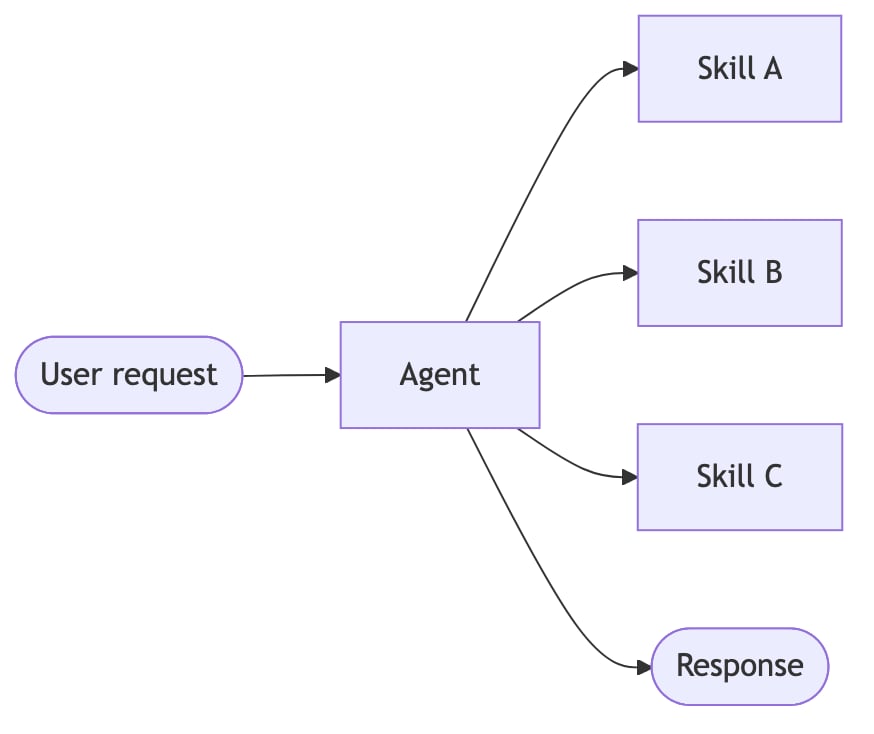
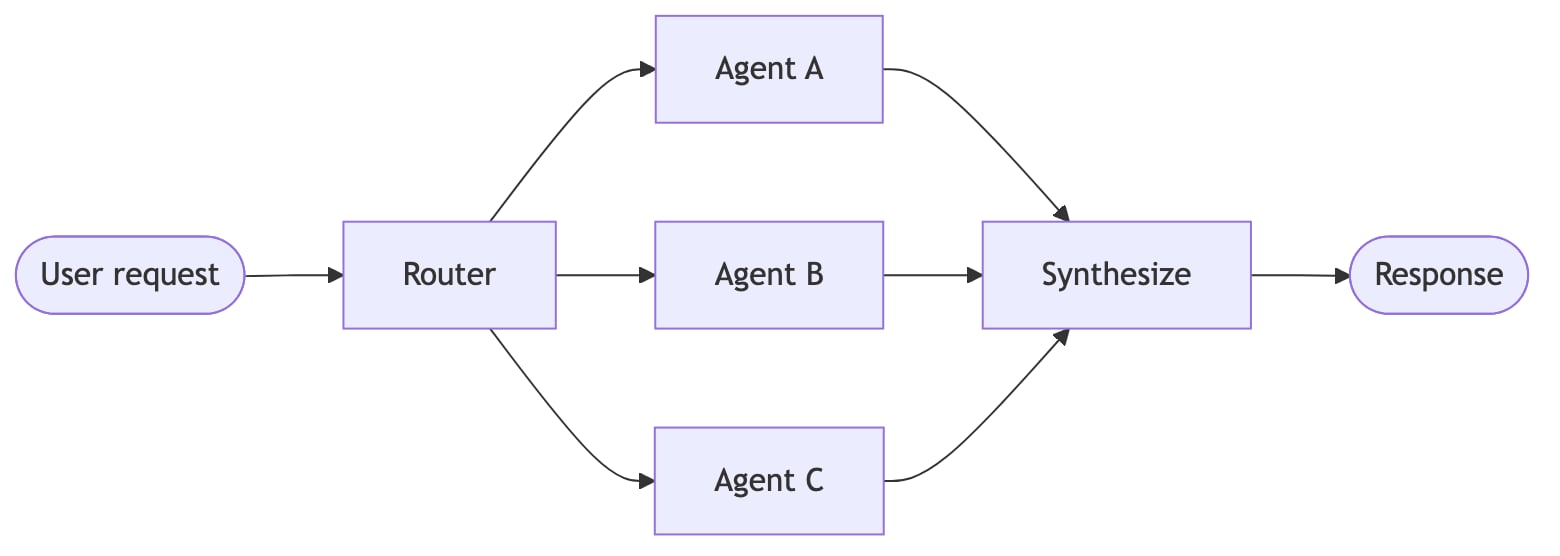
性能比较
不同的模式具有不同的性能特征。理解这些权衡有助于您根据延迟和成本需求选择合适的模式。 关键指标:- 模型调用次数:LLM 调用的次数。调用次数越多 = 延迟越高(尤其是顺序调用)和每请求 API 成本越高。
- 处理的 Token 数量:所有调用中 context window 的总使用量。Token 数量越多 = 处理成本越高和潜在的上下文限制。
单次请求
用户: “买咖啡”一个专用的咖啡智能体/技能可以调用一个
buy_coffee 工具。
- Subagents
- Handoffs
- Skills
- Router
4 次模型调用: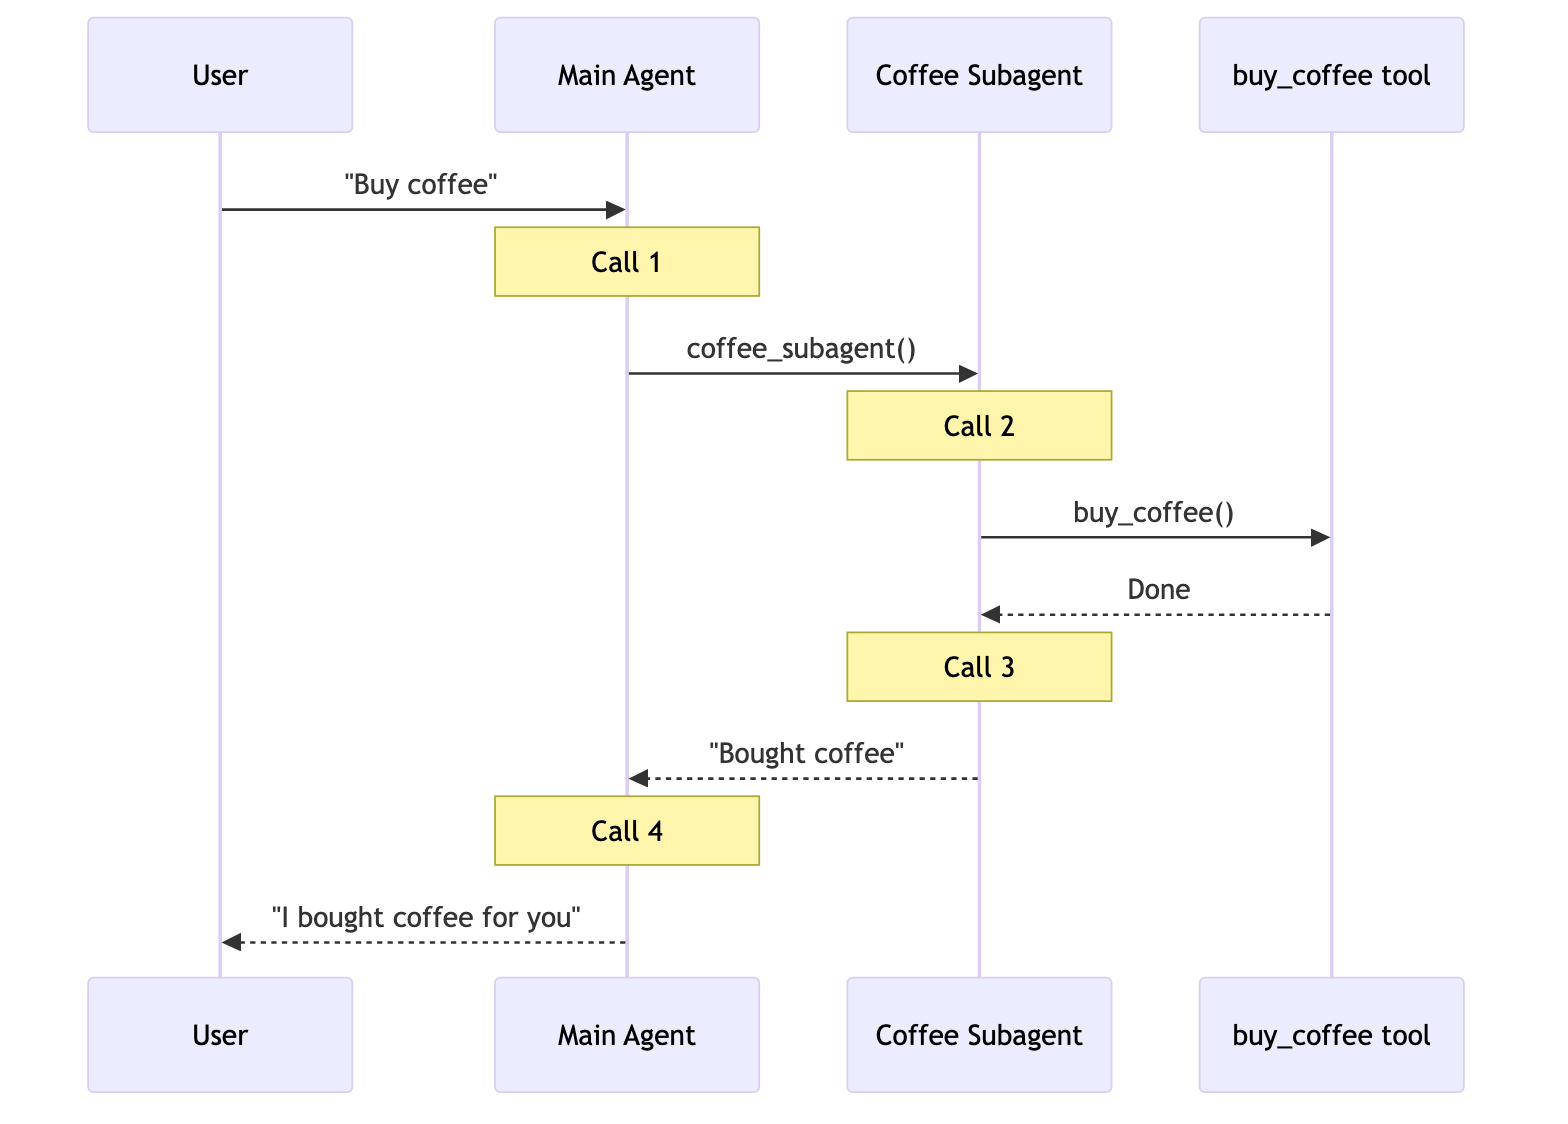
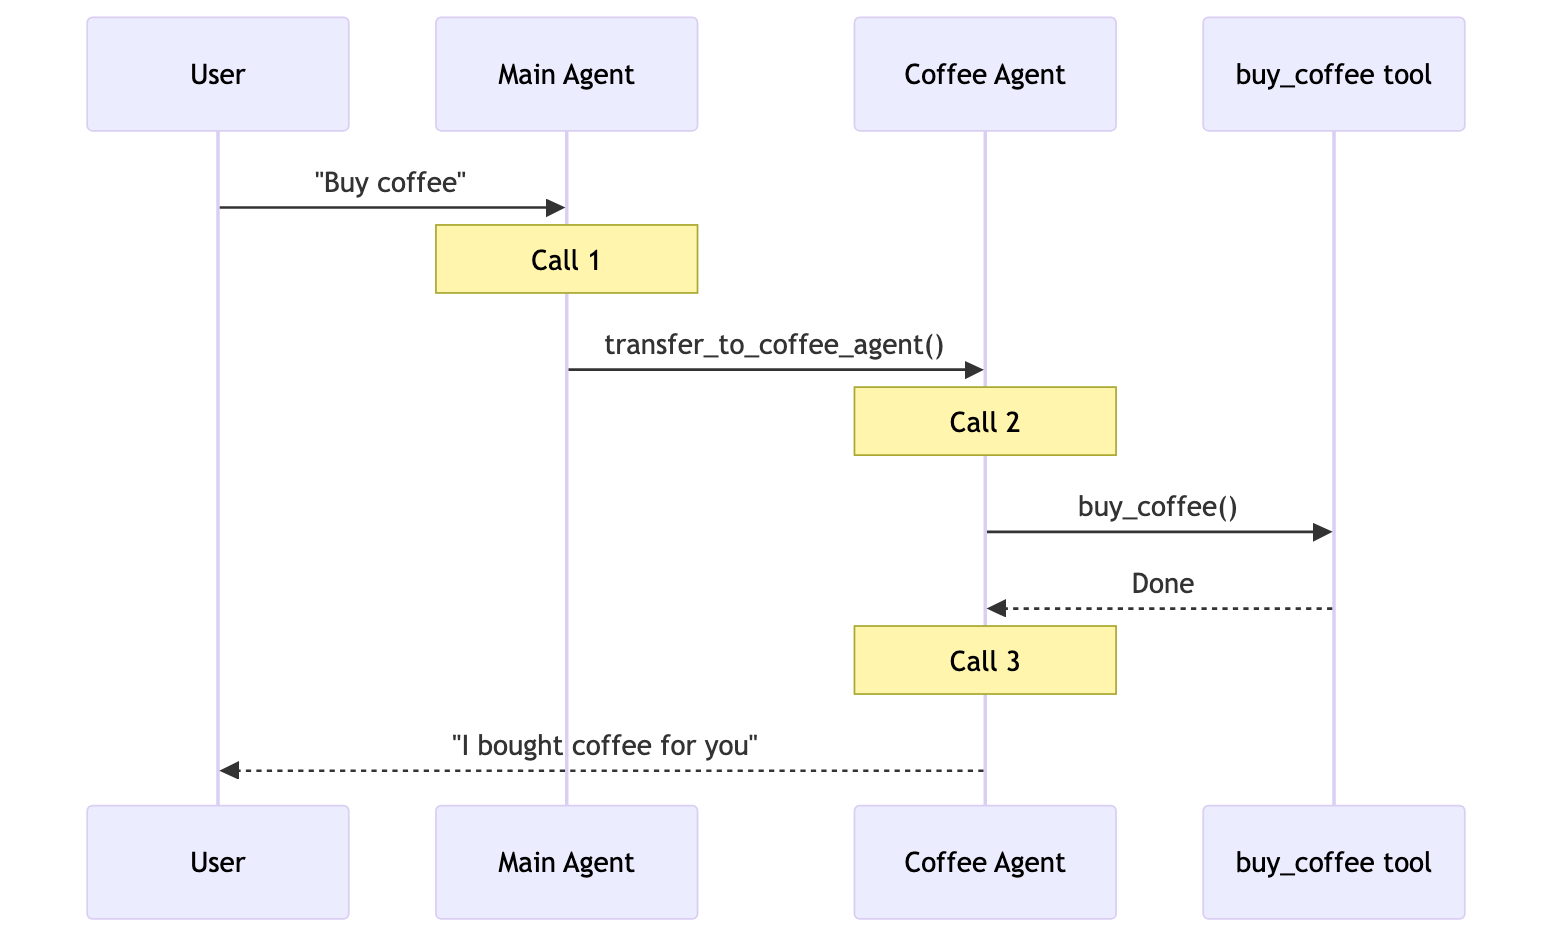
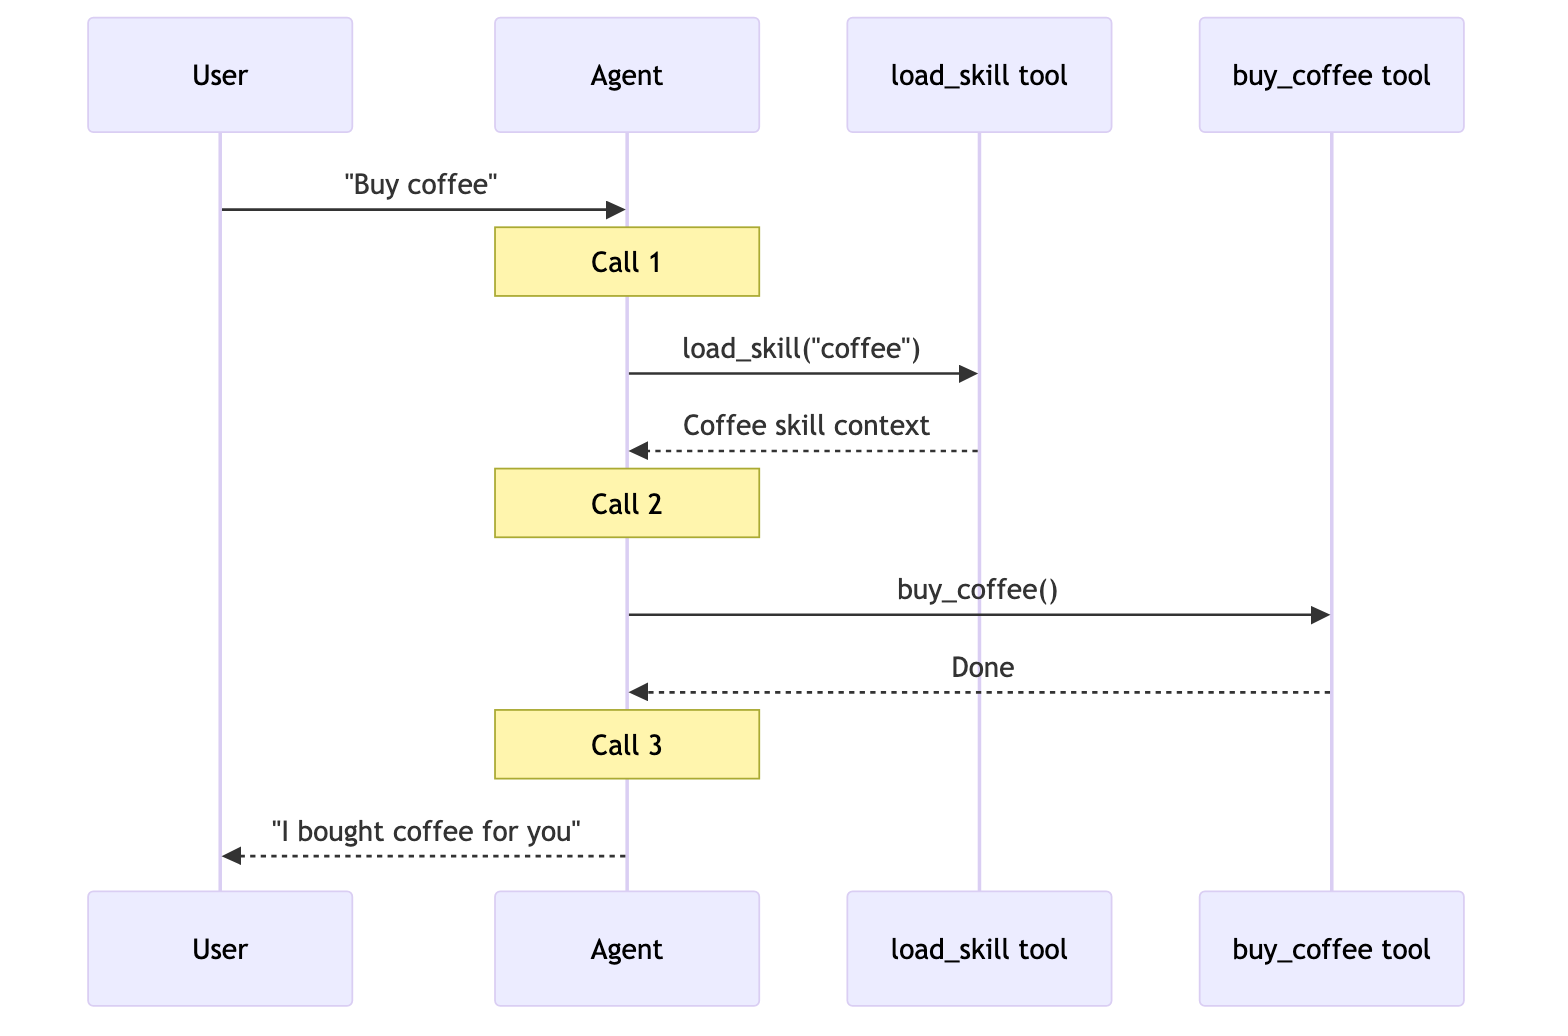
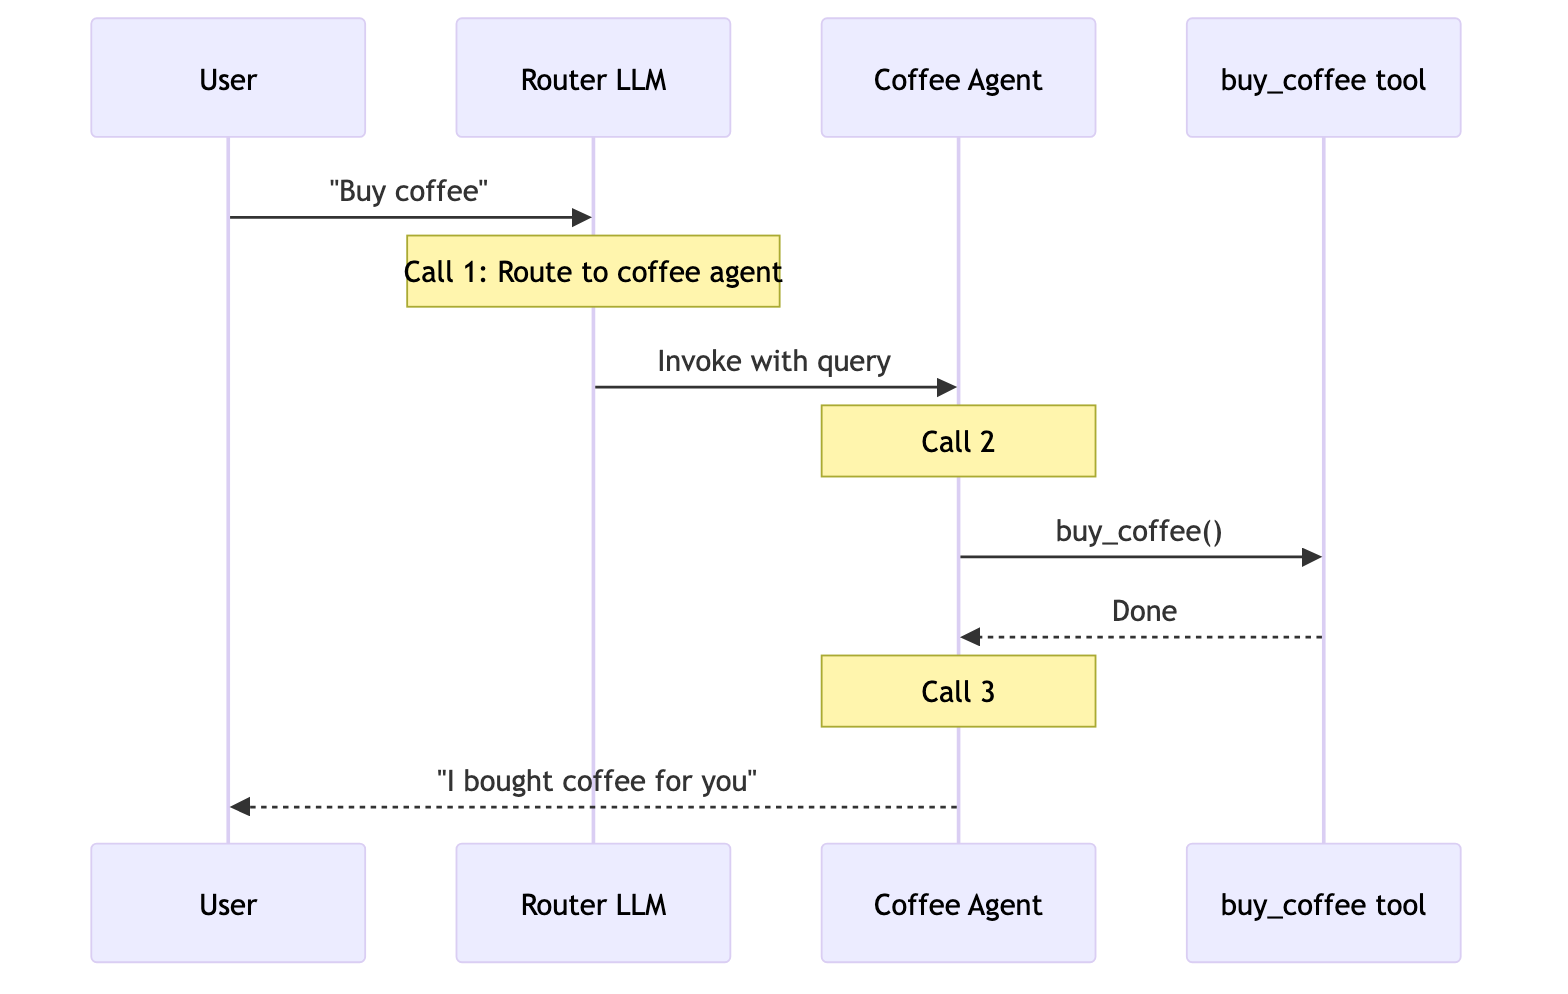
重复请求
回合1: “买咖啡” 回合2: “再买咖啡”用户在同一个对话中重复相同请求。
- Subagents
- Handoffs
- Skills
- Router
再次4次调用 → 总计8次
- 子智能体按设计无状态——每次调用遵循相同流程
- 主智能体维护对话上下文,但子智能体每次都重新开始
- 这提供了强上下文隔离,但重复完整流程
多领域
用户: “比较Python、JavaScript和Rust用于Web开发”每个语言智能体/技能包含约2000个Token的文档。所有模式都可以进行并行工具调用。
- Subagents
- Handoffs
- Skills
- Router
5次调用,~9K Token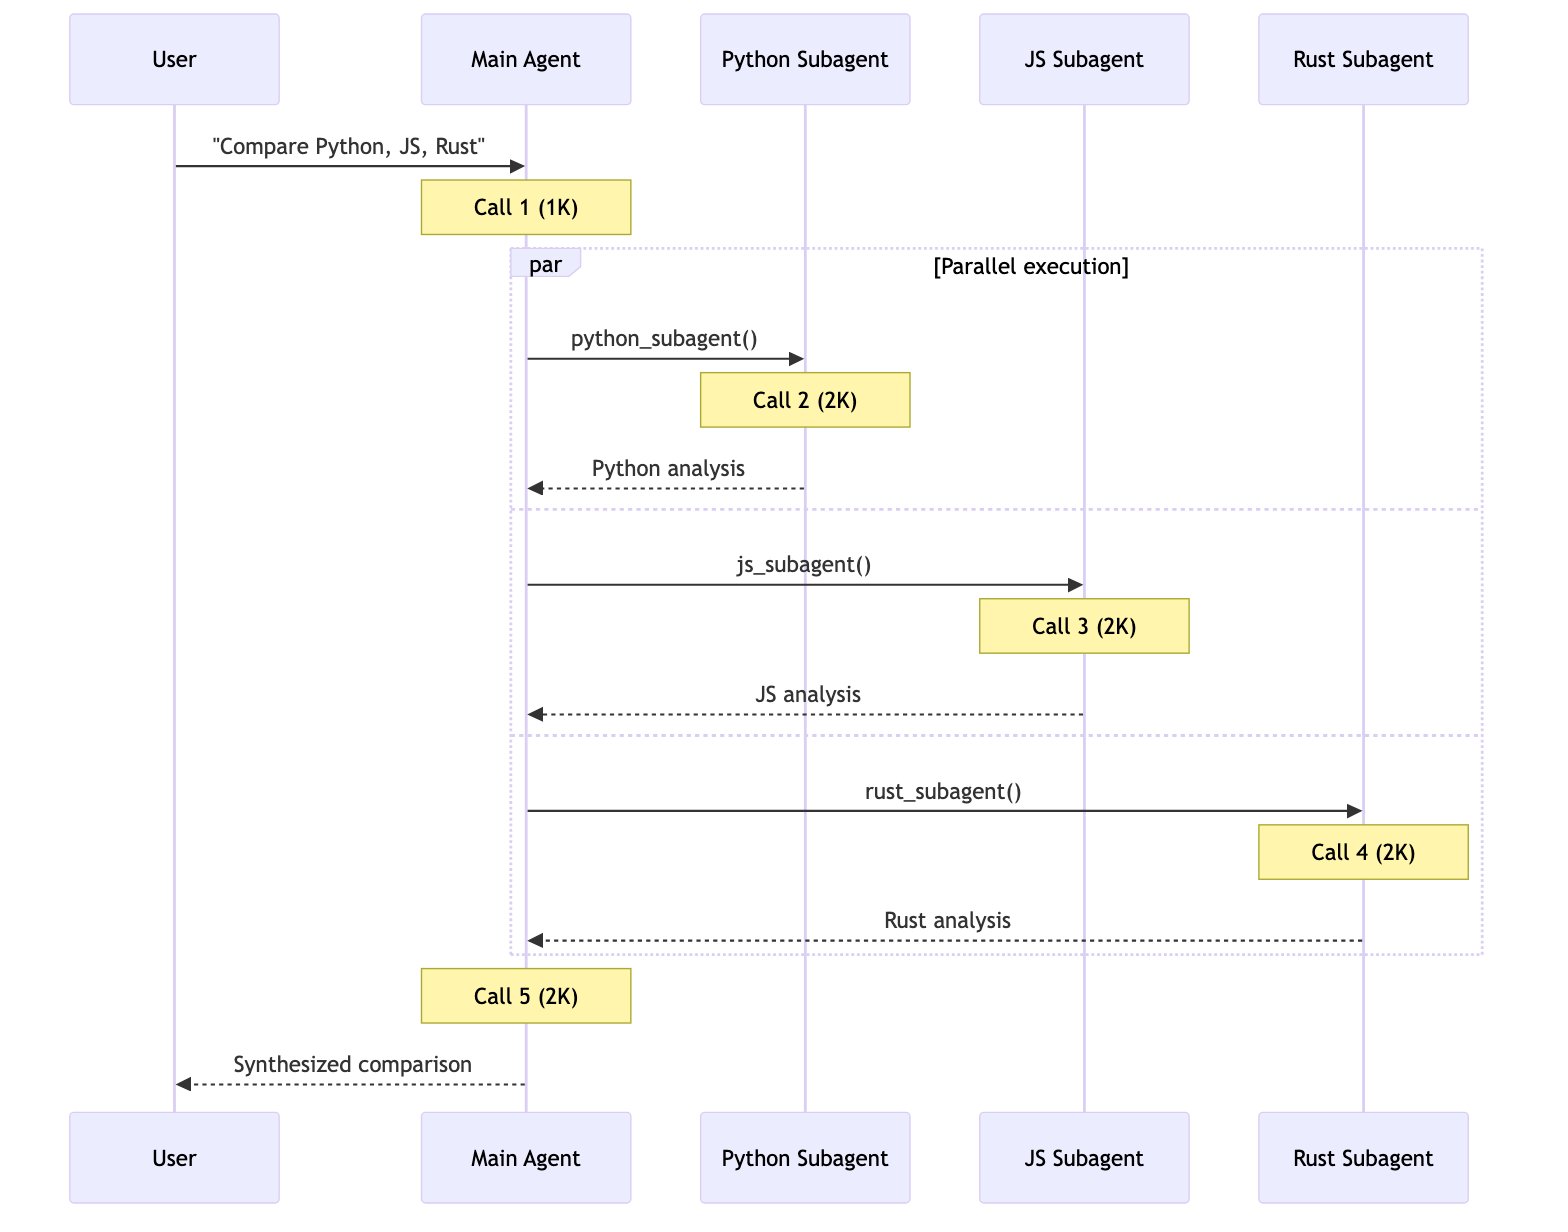
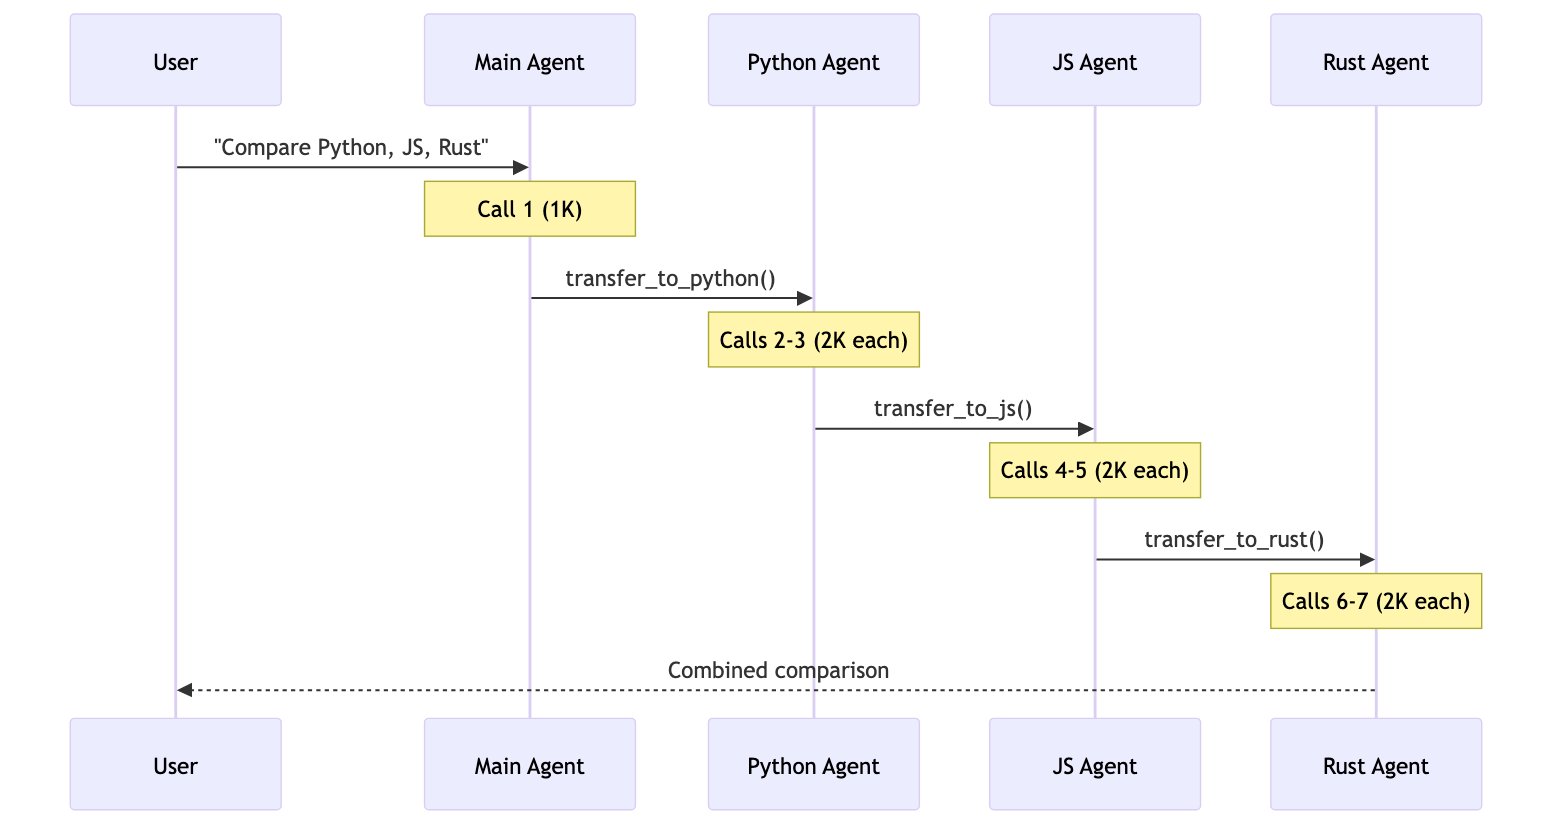
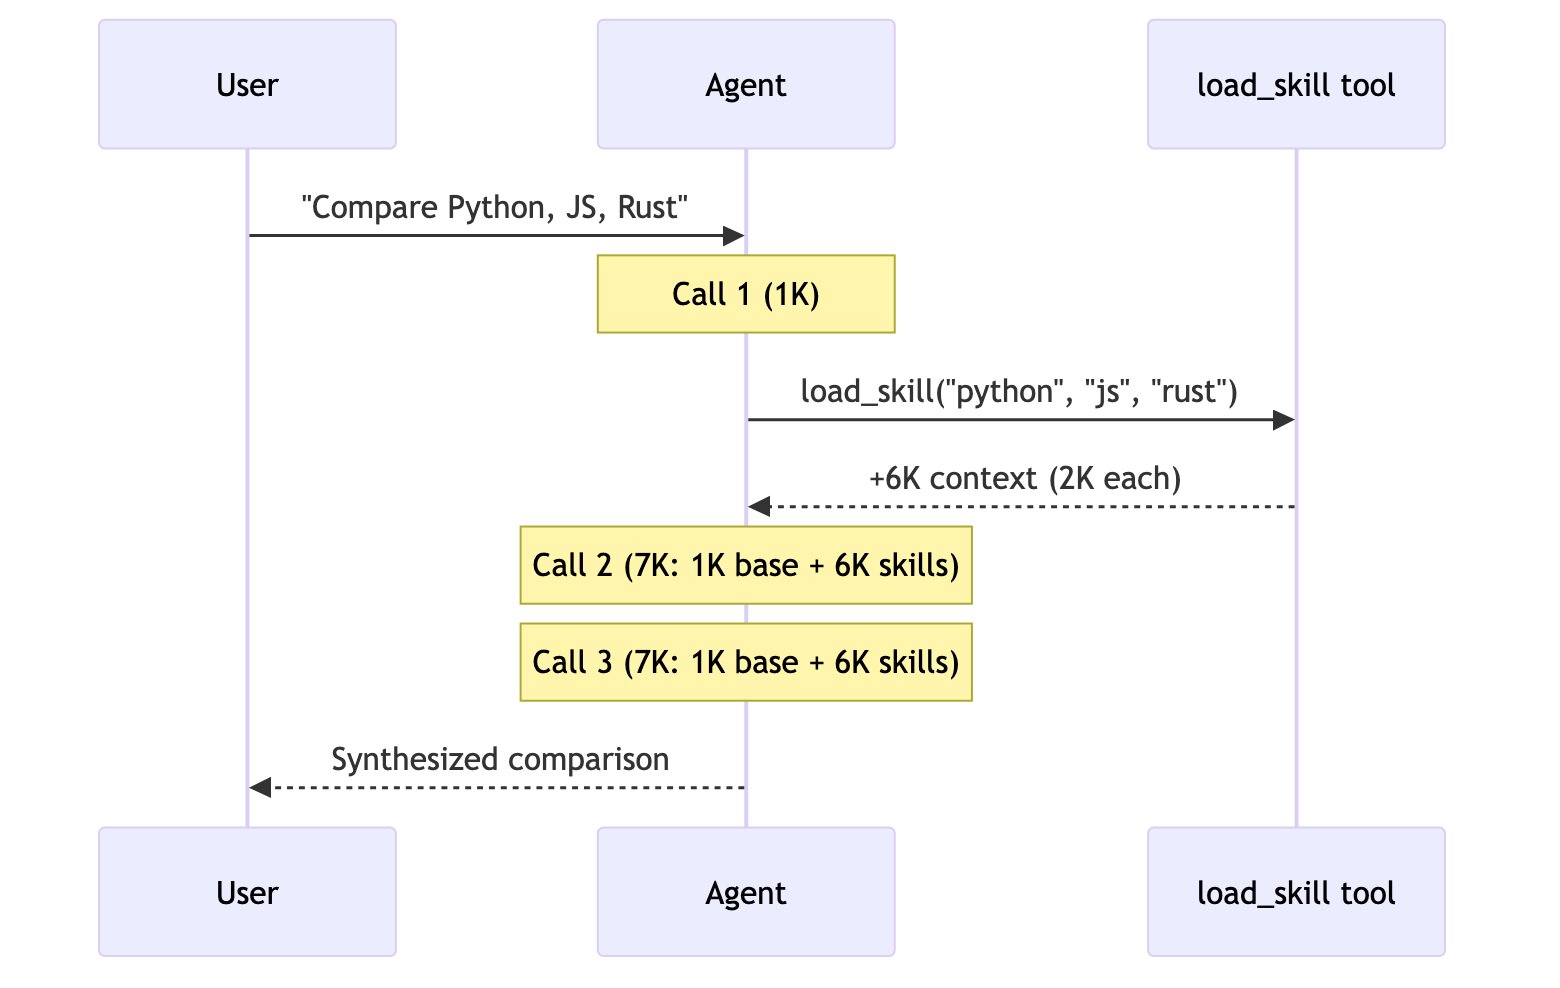
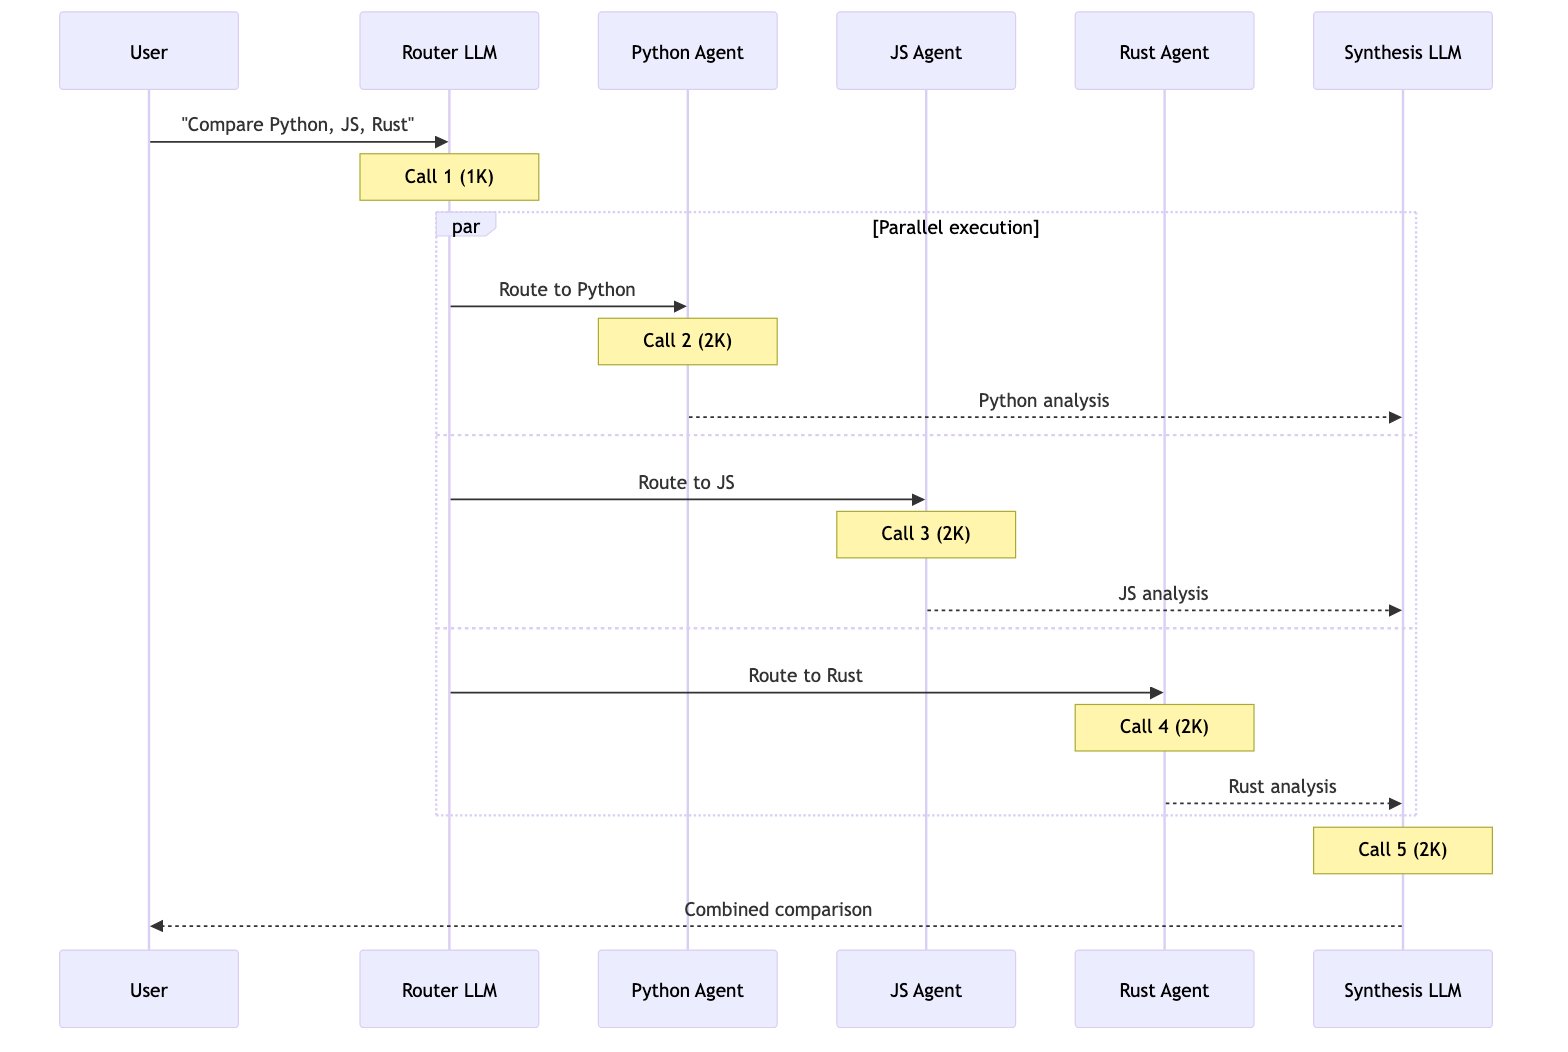
总结
以下是三种场景中模式的对比:官方原文:src/oss/langchain/multi-agent/index.mdx · 非官方翻译,译文由 AI 生成,以英文原文为准。