Agent Server 自动处理 stores
使用 Agent Server 时,您无需手动实现或配置 stores。API 会在幕后为您处理所有存储基础设施。
@[InMemoryStore] 适用于开发和测试。在生产环境中,请使用持久化存储,如
PostgresStore、MongoDBStore、RedisStore 或 UpstashStore。所有实现都扩展自 @[BaseStore],这是在节点函数签名中使用的类型注解。查看 store integrations 以获取可用提供商的完整列表。
基本用法
以下代码片段展示了在不使用 LangGraph 的情况下,单独使用 @[InMemoryStore]: :::pythontuple 进行命名空间划分,在下面的示例中,(<user_id>, "memories")。命名空间可以是任意长度并代表任何内容,不必特定于用户。
:::python
store.put 方法将 memories 保存到 store 中的命名空间。指定上面定义的命名空间以及记忆的键值对:键只是记忆的唯一标识符 (memory_id),而值(字典)就是记忆本身。
:::python
store.search 方法从命名空间中读取 memories,该方法将给定用户的 memories 作为列表返回,最多返回 limit 个参数(默认 10)。使用 InMemoryStore 时,项目按插入顺序返回,因此最新的 memory 位于列表末尾;其他后端可能会以不同方式对 memories 进行排序(参见 Listing items in a namespace)。
:::python
Item)。我们可以通过使用 .dict 进行转换,将其作为字典访问。
它具有以下属性:
value: 此 memory 的值(本身是一个字典)key: 此 memory 在此命名空间中的唯一键namespace: 字符串元组,此 memory type 的命名空间
当类型为
tuple[str, ...] 时,在转换为 JSON 时可能被序列化为列表(例如,['1', 'memories'])。created_at: 此 memory 创建的时间戳updated_at: 此 memory 更新的时间戳
value: 此 memory 的值key: 此 memory 在此命名空间中的唯一键namespace: 字符串元组,此 memory type 的命名空间
当类型为
tuple 时,在转换为 JSON 时可能被序列化为列表(例如,['1', 'memories'])。createdAt: 此 memory 创建的时间戳updatedAt: 此 memory 更新的时间戳
列出命名空间中的项目
:::python 调用store.search(或异步的 store.asearch)而不带 query 和 filter 会返回存储在 namespace_prefix 下的项目,最多返回 limit 个。当你不需要语义排序时,用它来枚举命名空间中的所有内容。
:::
:::js
调用 store.search 而不提供 query 和 filter 将返回在命名空间前缀下存储的项目,最多返回 limit 个。当您不需要语义排序时,使用此方法来枚举命名空间中的所有内容。
:::
:::python
namespace_prefix通过前缀匹配,而非精确匹配。("alice",)也会返回("alice", "memories")、("alice", "preferences")等子项。若要限制为单一层级,请传递完整命名空间或在item.namespace客户端过滤返回项。- 超过
limit的结果会被静默截断。 没有溢出信号—将limit设置为预期最大值以上,或使用offset进行分页。 - 默认排序取决于存储后端。
PostgresStore和AsyncPostgresStore按updated_at降序返回结果(最近更新优先)。InMemoryStore按插入顺序返回结果(最近插入的排在最后)。不要依赖跨实现的特定顺序;若顺序重要,请在item.updated_at客户端进行排序。
store.list_namespaces 或 store.alist_namespaces:
store.listNamespaces:
语义搜索
除了简单的检索外,store 还支持语义搜索,允许您根据含义而非精确匹配来查找 memories。要启用此功能,请使用嵌入模型配置 store: :::pythonfields 参数或在存储 memories 时指定 index 参数来控制 memories 的哪些部分被嵌入:
:::python
在 LangGraph 中使用
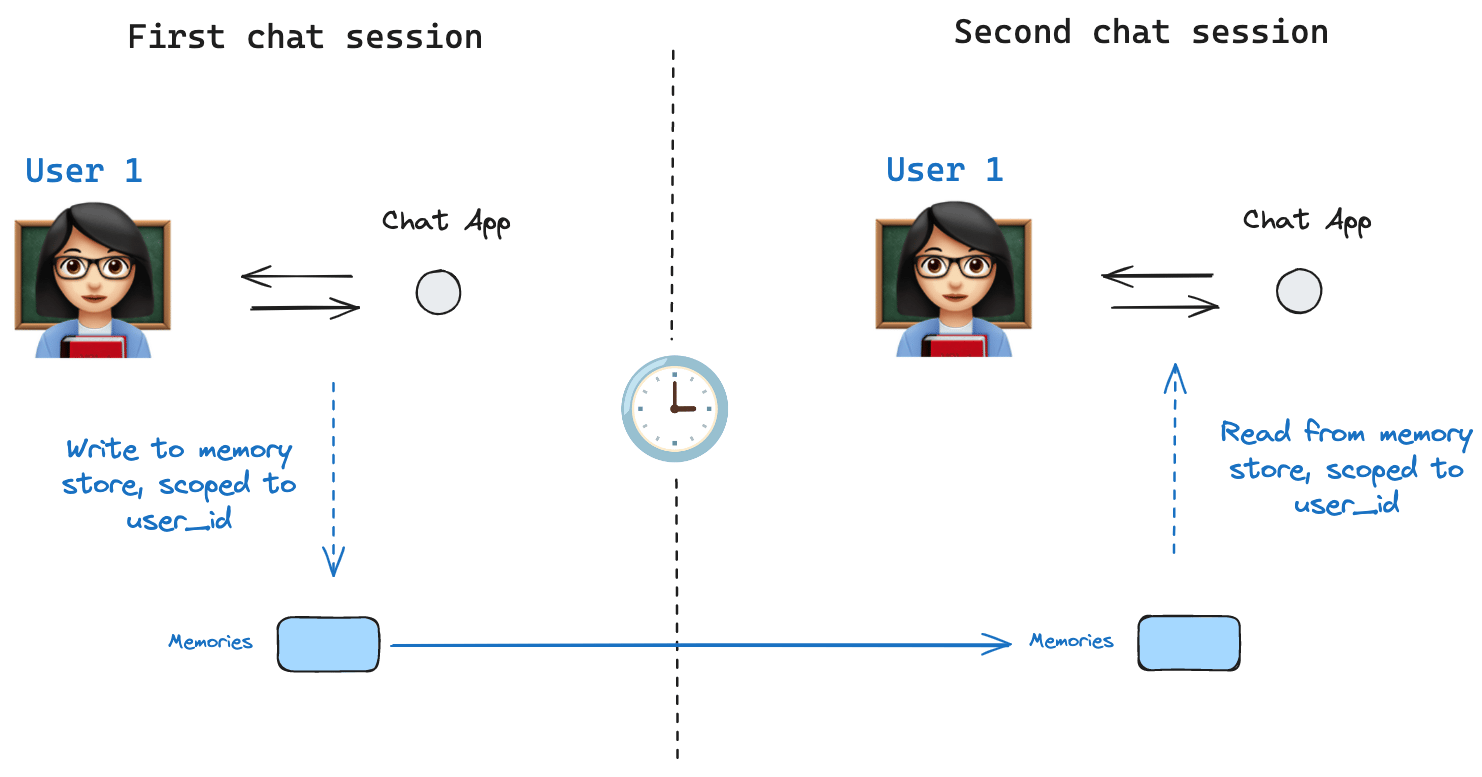
:::python store 与 checkpointer 紧密配合工作:checkpointer 将状态保存到线程(如上所述),而 store 允许您存储任意信息以供 跨 线程访问。请按如下方式同时使用 checkpointer 和 store 编译图。memoryStore 与检查点协同工作:检查点将状态保存到线程中(如前所述),而 memoryStore 允许您存储任意信息以跨线程访问。以下是如何编译包含检查点和 memoryStore 的图。
thread_id 调用图,并使用 user_id,它作为此特定用户的记忆命名空间,如前所述。
:::python
Runtime 对象从 任何节点 访问存储和 user_id。当您将 Runtime 作为参数添加到节点函数时,LangGraph 会自动注入 Runtime。您可以使用它来保存记忆:
runtime 参数从 任何节点 访问存储和 userId。您可以使用它来保存记忆:
store.search 方法获取记忆。记忆以对象列表的形式返回,可以转换为字典。
:::python
user_id 相同,您仍然可以访问相同的记忆。
:::python
langgraph.json 文件中配置索引设置。例如:
构建自定义存储
要使用除内置实现之外的存储后端,请继承 @[BaseStore] 并实现其所需方法。内置 @[InMemoryStore] 是最简单的参考实现。基本协议
所有五个异步方法都是必需的。同步对应方法(put、get、delete、search、list_namespaces)是可选的但建议与同步图执行兼容。
实现前请查找确切签名:
命名空间设计
命名空间是字符串元组,例如("user_id", "memories")。存储实现必须支持:
- 前缀匹配:
asearch(("alice",))返回("alice",)、("alice", "memories")和任何其他子命名空间下的项。 - 精确键查找:
aget(("alice", "memories"), "some-key")必须是 O(1) 或接近 O(1)。
序列化
存储值是普通的 Python 字典——无需特殊序列化器。使用json.dumps / json.loads 或直接使用 JSONB 列进行序列化。不要存储非 JSON-可序列化的原始 Python 对象。
语义搜索支持
如果您的后端支持向量搜索,请在asearch 上实现 query 参数:
- 接受一个
query: str | None参数。 - 当
query不为None时,嵌入它并按余弦相似度对结果进行排序。 - 当提供
query时,结果应在每个Item中包含score字段。
query 被传递时,请引发 NotImplementedError。
测试
目前还没有自定义存储的兼容性套件。将 @[InMemoryStore] 作为参考进行测试:下一步
- 向 Agent Server 添加自定义存储 — 部署您的实现
- 检查点 — 线程范围状态持久化
官方原文:src/oss/langgraph/stores.mdx · 非官方翻译,译文由 AI 生成,以英文原文为准。