本页面涵盖 长期记忆:跨对话持久存在的记忆。有关短期记忆(单个会话中的对话历史记录和临时文件),请参阅 context engineering 指南。短期记忆作为智能体 state 的一部分自动管理。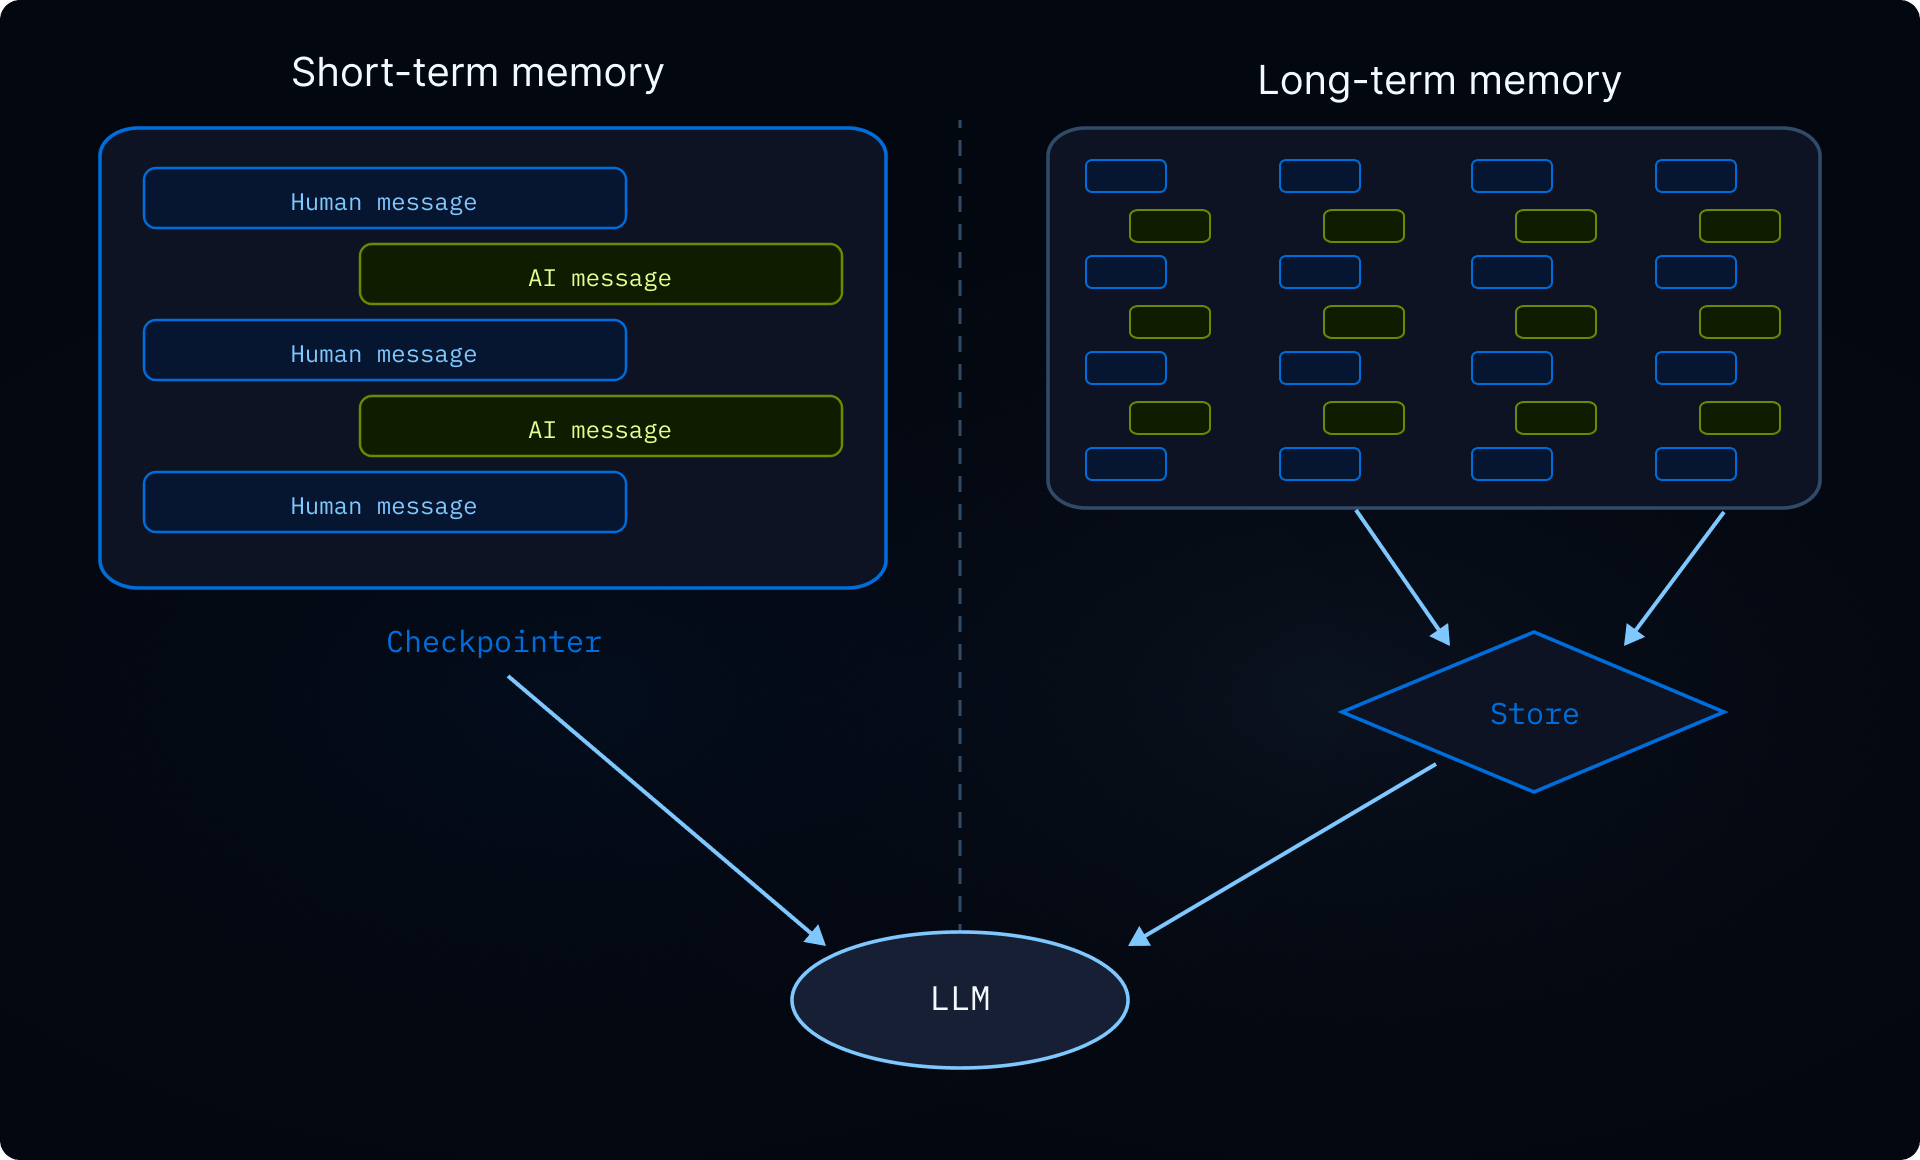
记忆如何工作
- 将智能体指向记忆文件。 在创建智能体时将文件路径传递给
memory=。您还可以通过skills=传递 skills 以进行程序性记忆(可重用的指令,告诉智能体 如何 执行任务)。backend 控制文件存储位置和访问权限。 - 智能体读取记忆。 智能体可以在启动时将记忆文件加载到系统提示中,或在对话期间按需读取。例如,skills 使用按需加载:智能体在启动时仅读取技能描述,然后在匹配任务时才读取完整的技能文件。这使上下文保持精简,直到需要功能时。
- 智能体更新记忆(可选)。 当智能体学习到新信息时,它可以使用其内置的
edit_file工具来更新记忆文件。更新可以在对话期间发生(默认情况下)或在对话之间通过 background consolidation 在后台发生。更改会被持久化并在下一个对话中可用。并非所有记忆都是可写的:开发者定义的 skills 和 organization policies 通常为只读。有关 read-only vs writable memory 的详细信息,请参阅。
AGENTS.md 发现的生成的仓库维基,请参阅 OpenWiki。
作用域记忆
智能体记忆可以作用域化,以便所有使用智能体的用户都可以访问相同的记忆文件,或者每个用户的记忆文件可以独立。智能体作用域记忆
给智能体一个随时间演变的持久身份。智能体作用域记忆跨所有用户共享,因此智能体通过每次对话建立自己的角色、积累的知识和学习到的偏好。随着与用户的互动,它发展专业知识,改进方法,并记住哪些方法有效。它还可以在具有写权限时学习和更新 skills。 关键是后端命名空间:将其设置为(assistant_id,) 意味着该智能体的每个对话都读取和写入相同的记忆文件。
:::python
访问
rt.server_info 需要 deepagents>=0.5.0。在旧版本中,从 get_config()["metadata"]["assistant_id"] 读取助手 ID。访问
rt.serverInfo 需要 deepagents>=1.9.0。在旧版本中,从 getConfig().metadata.assistantId 读取助手 ID。Full example: seed memory and invoke
Full example: seed memory and invoke
用初始记忆填充存储,然后在两个线程中调用智能体,以查看它如何记住和更新所学内容。:::python::::::js:::
用户作用域记忆
给每个用户自己的记忆文件。智能体按用户记住偏好、上下文和历史记录,而核心智能体指令保持固定。如果存储在用户作用域后端,用户还可以有自己的 skills。 命名空间使用(user_id,),因此每个用户都获得记忆文件的独立副本。用户 A 的偏好永远不会泄露到用户 B 的对话中。
:::python
Full example: isolated memory across users
Full example: isolated memory across users
为每个用户种子记忆,然后以两个不同的用户身份调用智能体。每个用户只能看到自己的偏好。:::python::::::js:::
高级用法
除了记忆路径和作用域的基本配置选项,您还可以配置记忆的高级参数:情景记忆
Episodic memory 存储过去经历的记录:发生了什么、顺序是什么、结果是什么。与存储在文件(如AGENTS.md)中的事实和偏好(semantic memory)不同,episodic memory 保留完整的对话上下文,以便智能体可以回忆 如何 解决问题,而不仅仅是 学到了什么。要生成和维护用于编码智能体的仓库级维基,请参阅 OpenWiki。
Deep Agents 已经使用 checkpointers,这是支持 episodic memory 的机制:每个对话都作为检查点线程持久化。
要使过去的对话可搜索,请将线程搜索包装在工具中。user_id 从运行时上下文中获取,而不是作为参数传递:
:::python
组织级记忆
组织级记忆遵循与用户级记忆相同的模式,但使用的是全局命名空间而非每个用户的命名空间。用于跨所有用户和智能体的策略或知识。 组织记忆通常是 只读 的,以防止通过共享状态进行提示词注入。详情请参阅 只读与可写记忆。 :::python背景整合
默认情况下,智能体在对话期间(热点路径)写入记忆。另一种替代方案是在对话之间作为后台任务处理记忆,有时称为 睡眠时间计算。一个独立的深度智能体会审查最近的对话,提取关键事实,并将它们与现有记忆合并。
对于大多数应用,热点路径就足够了。当您需要减少延迟或在多个对话中提高记忆质量时,添加后台整合。
推荐的模式是在您的智能体旁边部署一个 整合智能体 — 一个深度智能体,它读取最近的对话历史,提取关键事实,并将它们合并到记忆存储中 — 并在 cron 定时任务 上触发它。选择一个反映您的用户实际与智能体交互频率的时间间隔:一个具有稳定每日流量的聊天产品可能每小时整合几次,而每周只使用几次的工具只需要每天或每周运行一次。比用户交互更频繁地整合只是在无操作运行中消耗 Token。
整合智能体
整合智能体读取最近的对话历史并将关键事实合并到记忆存储中。在langgraph.json 中与您的智能体一起注册:
:::python
consolidation_agent.py
src/consolidation-agent.ts
langgraph.json
langgraph.json
Cron
一个 cron 任务 按固定时间表运行整合智能体。智能体搜索最近的对话并将它们综合到记忆中。根据您的使用模式匹配时间表,以便整合大致跟踪实际活动。 使用 cron 任务调度整合智能体: :::python所有 cron 时间表都按 UTC 解释。有关管理和删除 cron 任务的详细信息,请参阅 cron 任务。
只读与可写记忆
默认情况下,智能体可以读写记忆文件。对于共享状态(如组织策略或合规规则),您可能希望将记忆设为 只读,以便智能体可以引用它但不能修改它。这可以防止通过共享记忆进行提示词注入,并确保只有您的应用代码控制文件中的内容。
安全注意事项:如果一个用户可以向另一个用户读取的记忆写入,恶意用户可能会向共享状态注入指令。为缓解此问题:
- 默认使用用户范围
(user_id),除非您有特定原因要共享 - 使用 只读记忆 用于共享策略(通过应用代码填充,而不是智能体)
- 在智能体向共享记忆写入之前添加 人工审核 验证。使用 中断 要求对敏感路径的写入进行人工批准。
并发写入
多个线程可以并行写入记忆,但向 同一文件 的并发写入会导致最后写入者胜出的冲突。对于用户级记忆这种情况很少见,因为用户通常一次只有一个活动对话。对于智能体级或组织级记忆,考虑使用 后台整合 来序列化写入,或将记忆结构化为每个主题的单独文件以减少争用。 实际上,如果由于冲突而写入失败,LLM 通常足够智能可以重试或优雅地恢复,因此单个丢失的写入不是灾难性的。同一部署中的多个智能体
要在共享部署中为每个智能体提供自己的记忆,将assistant_id 添加到命名空间中:
:::python
assistant_id。
参见
- OpenWiki: 生成和维护编码智能体通过
AGENTS.md找到的仓库维基 - Backends: 选择记忆文件存储位置
- Context engineering: 短期记忆、卸载和摘要
- Skills: 按需程序性记忆
官方原文:src/oss/deepagents/memory.mdx · 非官方翻译,译文由 AI 生成,以英文原文为准。