- 拉取并预处理用于检索的文档
- 对分割后的文档进行语义搜索索引,并为智能体创建检索工具
- 构建具备决策能力的 RAG 系统以决定何时使用检索工具

概念
本教程涵盖以下核心概念:配置
安装所需包并设置 API 密钥: :::python配置 LangSmith
RAG 应用程序按顺序执行检索和生成操作。本教程中的示例运行时,LangSmith 会为每个查询记录追踪信息,便于检查检索、工具调用和模型响应。 完成LangSmith注册后,设置环境变量以启用追踪记录:预处理文档
:::python1
Fetch documents
使用Lilian Weng’s blog的三篇博客文章。通过基于
requests和BeautifulSoup构建的简易助手获取页面内容。2
Split documents
将获取的文档分割为小块以便向向量存储索引:
1
Fetch documents
使用Lilian Weng’s blog的三篇近期文章。通过基于
fetch和cheerio构建的简易助手获取页面内容:2
Split documents
将获取的文档分割为小块以便向向量存储索引:
创建检索工具
将分割后的文档向向量存储进行语义索引。 :::python1
Index documents
使用内存向量存储和 OpenAI 嵌入:
2
Create the retriever tool
通过
@tool装饰器创建检索工具:3
Test the tool
1
Index documents and create the tool
使用内存向量存储和 OpenAI 嵌入,然后用 LangChain 预构建的
createRetrieverTool 创建检索器工具:2
Test the tool
生成查询或响应
当检索器工具就绪后,开始构建LangGraph图中的智能体。在 Graph API, 一个图由以下组件构成: :::python- 状态: 节点读取并更新共享数据。本教程使用
MessagesState, 该组件存储一个messages列表,其中包含 对话消息。 :::
-
状态: 节点读取并更新共享数据。本教程使用
MessagesAnnotation, 该组件存储一个messages列表,其中包含 对话消息。 ::: - 节点: 函数接受当前状态,执行一个步骤(例如调用模型或工具),并返回状态更新。
- 边: 定义下一个运行的节点,包括 条件边] 根据状态分支的连接。
1
Build the node
构建
generate_query_or_respond 节点,调用模型处理当前消息,并将 retriever_tool 绑定到 .bind_tools:2
Try a simple greeting
3
Ask a retrieval question
提出需要语义搜索的问题:输出:
1
Build the node
构建
generateQueryOrRespond 节点,调用模型处理当前消息,并将 tools 绑定到 .bindTools:2
Try a simple greeting
3
Ask a retrieval question
提出需要语义搜索的问题:输出:
评估文档
普通边始终将图发送到同一下一个节点。一个 条件边] 在运行时通过计算当前状态决定下一个节点。在检索后,使用该模式评估文档相关性:若相关则继续生成回答,否则重写问题并重新尝试。 :::python1
Add document grading
添加
grade_documents 路由函数,使用具有结构化输出 schema GradeDocuments 的模型。根据评分决策(generate_answer 或 rewrite_question)返回下一个节点名称:2
Test with irrelevant documents
使用包含不相关文档的工具响应运行此流程:
3
Test with relevant documents
验证相关文档的归类:
1
Add document grading
添加一个使用具有结构化输出(Zod)模型的
gradeDocuments路由函数,若结构化解析失败则退化为简单的”是”或”否”响应。该函数根据评分决策(generate或rewrite)返回下一个节点的名称,因此应通过条件边调用而非直接添加节点:2
Test with irrelevant documents
在工具响应中包含无关文档进行测试:
3
Test with relevant documents
验证相关文档的归类:
重写问题
当评分者标记检索到的文档为无关时,图不应基于该上下文回答。相反,需将原始用户问题重写为更清晰的搜索查询,然后通过控制流返回到生成查询或响应节点,使智能体重新检索。这种重试循环帮助智能体从首次检索不足中恢复,而非停止或编造答案。 :::python1
Build the rewrite node
构建用于改进原始用户问题的
rewrite_question节点(当检索缺失时):2
Try it out
1
Build the rewrite node
构建用于改进原始用户问题的
rewrite节点(当检索缺失时):2
Try it out
生成答案
当评分者接受检索到的文档时,图进入答案生成阶段。此为经典的RAG步骤:将原始用户问题与包含检索上下文的工具消息结合,要求模型生成基于提供的上下文而非编造细节的答案。需保持提示词简洁,确保模型从给定上下文而非自行编造信息。 :::python1
Build the answer node
构建用于从问题和检索上下文生成最终回复的
generate_answer节点:2
Try it
1
Build the answer node
构建用于从问题和检索上下文生成最终回复的
generate节点:2
Try it
组装图
将节点和边组装为完整图: :::python- 从
generate_query_or_respond开始,判断是否需要调用retriever_tool。 - 根据模型是否进行工具调用决定下一步路由:
- 如果
generate_query_or_respond返回tool_calls,调用retriever_tool检索上下文。 - 否则直接向用户回复。
- 如果
- 对检索到的文档内容与问题的相关性(
grade_documents)进行评分,并决定下一步:- 如果不相关,使用
rewrite_question重写问题后再次调用generate_query_or_respond。 - 如果相关,进入
generate_answer,使用带有检索文档上下文的@[ToolMessage]生成最终响应。
- 如果不相关,使用
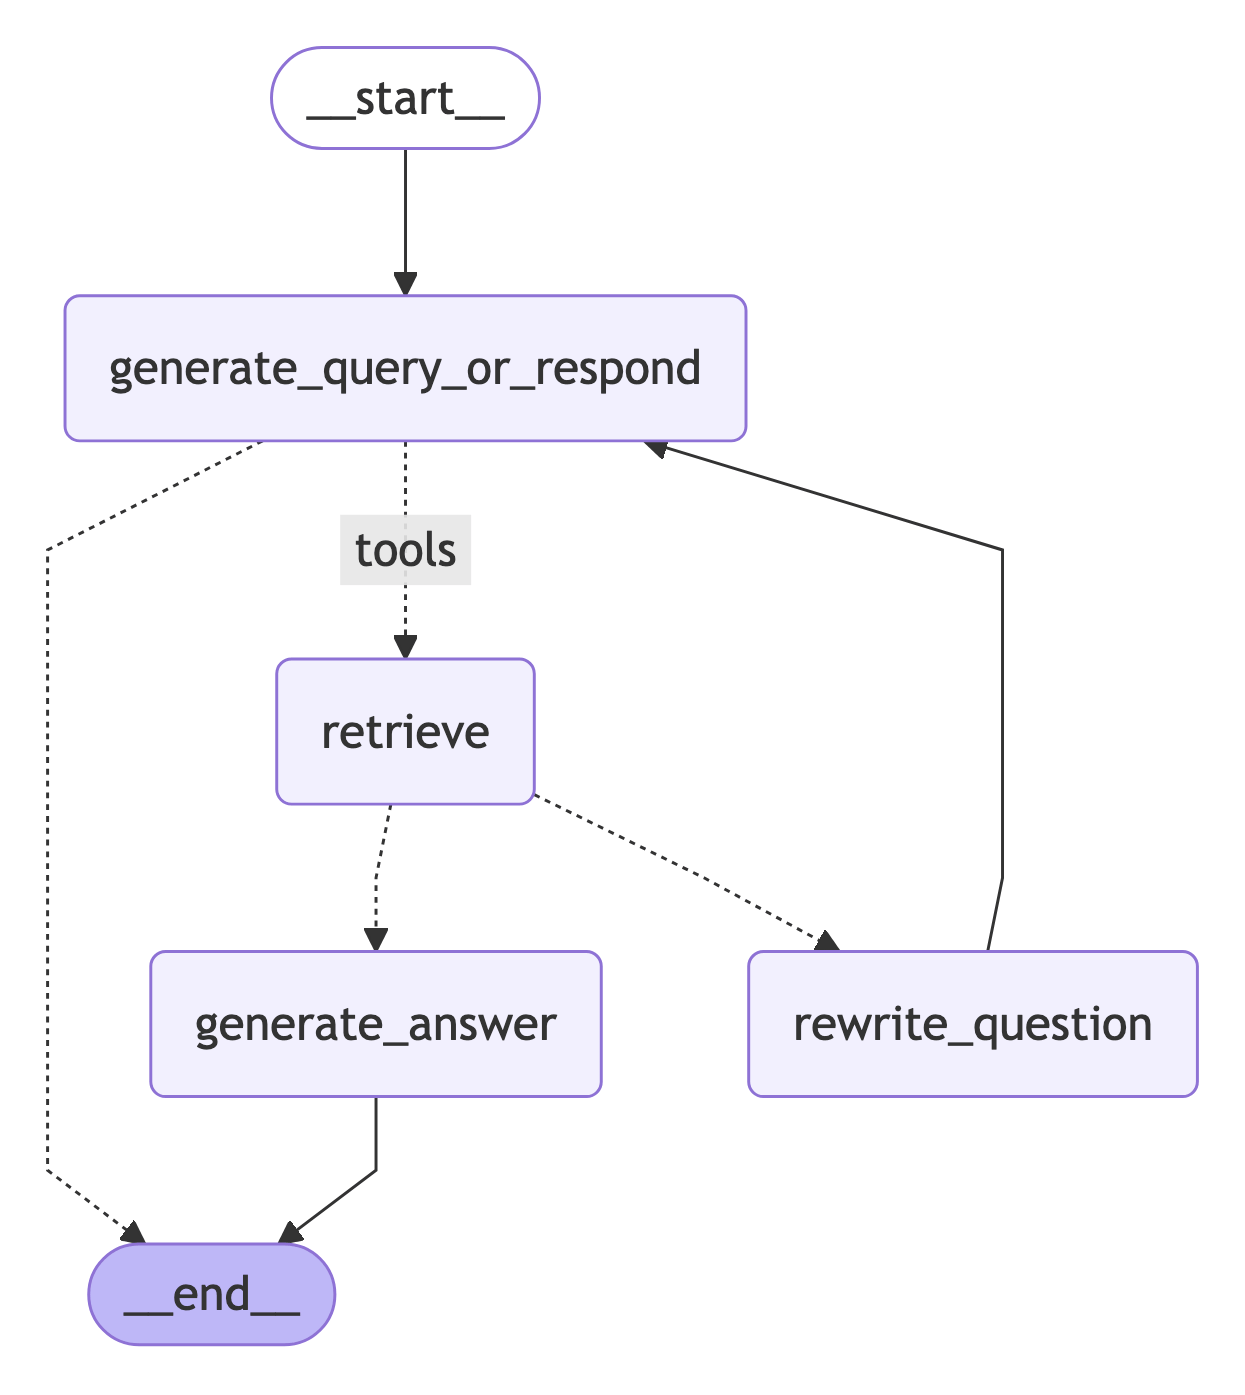
- 从
generateQueryOrRespond开始,判断是否调用检索器工具。 - 通过条件分支路由到下一步:
- 如果
generateQueryOrRespond返回tool_calls,调用检索器工具检索上下文。 - 否则直接向用户回复。
- 如果
- 对检索到的文档内容与问题的相关性(
gradeDocuments)进行评分,并决定下一步:- 如果不相关,使用
rewrite重写问题后再次调用generateQueryOrRespond。 - 如果相关,进入
generate,使用带有检索文档上下文的@[ToolMessage]生成最终响应。
- 如果不相关,使用
运行 agentic RAG
通过以下问题测试完整流程: :::python参考文档
官方原文:src/oss/langgraph/agentic-rag.mdx · 非官方翻译,译文由 AI 生成,以英文原文为准。